
✅ Alexa und Co. raus, lokale KI rein: Sprachsteuerung für Home Assistant komplett ohne Cloud, mit Wake Word am Lautsprecher, Whisper für Sprache-zu-Text, einem lokalen KI-Modell für die Steuerung und Piper für die Antwort. Ich habe das über mehrere Wochen aufgebaut, über 25 Modelle auf drei Hardware-Klassen gemessen und nutze es seitdem im Alltag. Hier stehen alle Messwerte, Einstellungen und meine Sprach-Automationen zum Kopieren, die im Video keinen Platz hatten. Und mein ehrliches Fazit, warum ich am Ende trotzdem nicht alles lokal betreibe.
Ehrlicher Hinweis vorab: Ich habe alles hier nach bestem Wissen und Gewissen getestet und dokumentiert. Das Umfeld rund um lokale KI-Modelle ändert sich wöchentlich, und ich bin kein Experte, sondern ein Smart-Home-Nutzer mit Messgerät. Technische Fehler meinerseits kann ich nicht ausschließen. Was ich versprechen kann: Jede Zahl hier stammt aus einer eigenen Messung, und ich sage dazu, wie sie entstanden ist.
🔒 Warum überhaupt lokal?
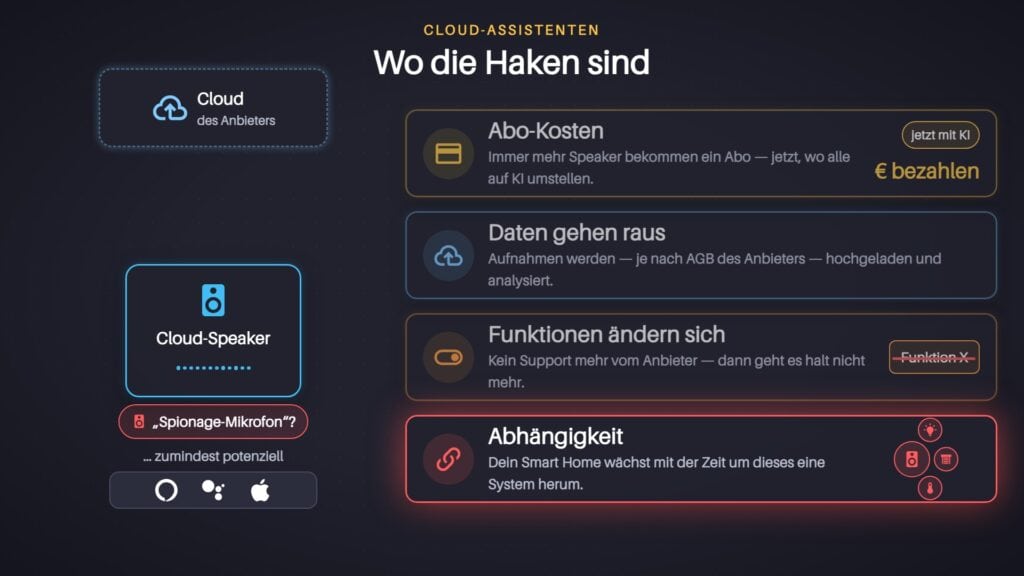
Alexa, Google und Siri funktionieren. Aber sie funktionieren nur so lange und so, wie es der Anbieter will. Alexa+ kommt mit Abo, Funktionen verschwinden mit dem nächsten Update, und jeder Sprachbefehl inklusive Audio wandert in ein Rechenzentrum. Wer ein Smart Home mit Home Assistant betreibt, hat den Rest ohnehin schon lokal. Die Sprachsteuerung war bisher das letzte Stück, das an der Cloud hing.
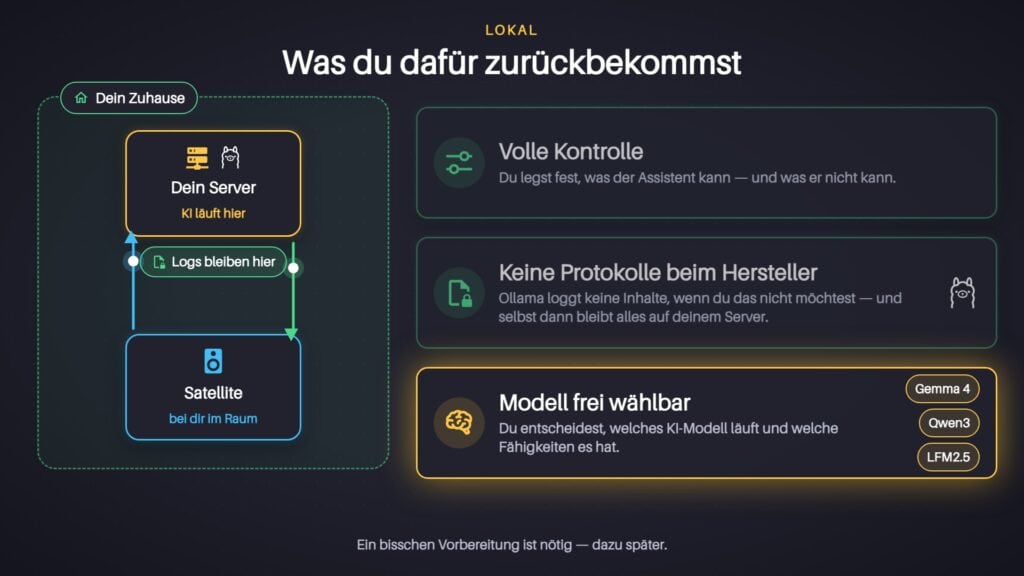
Ein Punkt, den ich im Video nur kurz anreiße, weil er sich schön belegen lässt: Ollama, der lokale Modell-Server, protokolliert keinerlei Inhalte. Ich habe drei Tage lang das Journal auf einen bekannten Testsatz durchsucht. Null Treffer. Geloggt werden nur Metadaten wie Zeitstempel, Modell, Tokenzahlen und Dauer. Bei Cloud-KI musst du der Datenschutzerklärung glauben. Hier kannst du ins Log schauen.
Und der andere Punkt, den ich genauso ehrlich sagen muss: Das ist 2026 machbar, aber kein Plug-and-Play. Wer den Komfort von Alexa ohne Basteln will, ist hier falsch. Wer bereit ist, ein Wochenende zu investieren und ein paar Hundert bis ein paar Tausend Euro in Hardware, bekommt dafür einen Assistenten, der wirklich dir gehört.
Geht es dir nur darum, nicht mehr von Amazon und Co. abhängig zu sein, geht das übrigens deutlich einfacher: mit einem Cloud-Sprachmodell hinter Home Assistant, wie in meinem n8n-Video. Hier geht es aber um die Frage, die unter jedem Sprachassistenten-Video in den Kommentaren steht: Geht das auch komplett lokal? Und zwar so, dass es sich wirklich nach KI anfühlt und nicht nur Licht an- und ausschaltet.
📹 Home Assistant Assist mit Cloud-KI über n8n: https://www.youtube.com/watch?v=K4uf1W6kcLE
🔗 So funktioniert die Kette
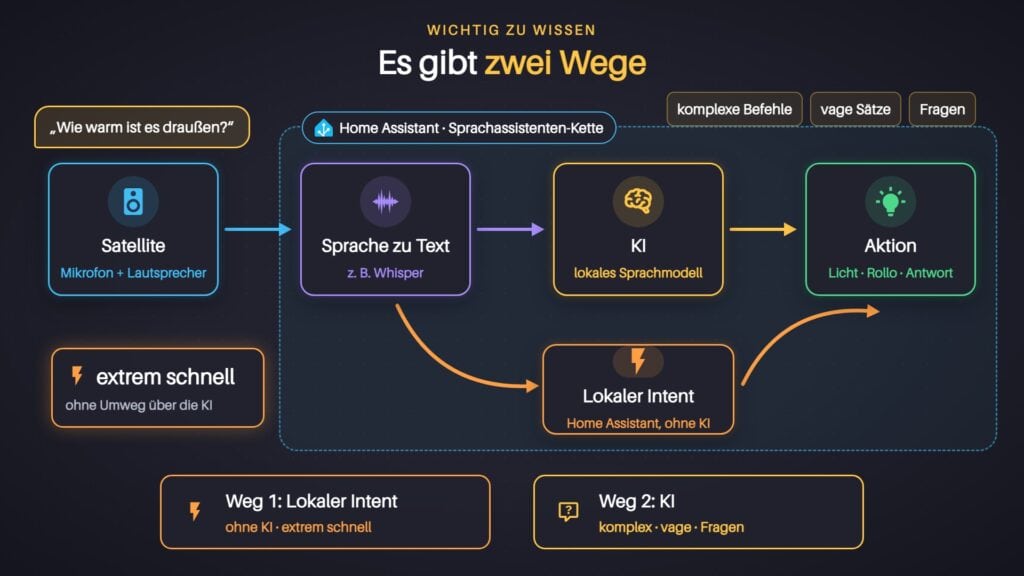
Ein Sprachbefehl durchläuft in Home Assistant immer dieselben Stationen. Wichtig ist, dass jede Station ein eigenes Stück Software ist, das auf eigener Hardware laufen kann:
- Wake Word („Okay Nabu“, „Hey Jarvis“): läuft direkt auf dem Lautsprecher (Satellit). Erst danach geht Audio überhaupt ins Netz.
- Sprache-zu-Text (STT): Whisper macht aus dem Audio einen Satz.
- Verstehen: Entweder erkennt Home Assistant den Satz selbst (eingebaute Intents, in Millisekunden), oder er geht an das KI-Modell.
- Aktion: Gerät schalten, Zustand abfragen, Skript starten.
- Text-zu-Sprache (TTS): Piper liest die Antwort vor.
Für Sprache-zu-Text und Text-zu-Sprache gibt es auch eine Cloud-Variante, die nichts mit Alexa und Co. zu tun hat: Home Assistant Cloud (Nabu Casa) bietet beides, deutlich schneller und genauer als Whisper und Piper lokal. Genau da bin ich am Ende gelandet, mehr dazu im Alltags-Kapitel.
Der wichtigste Schalter: „Lokale Verarbeitung bevorzugen“
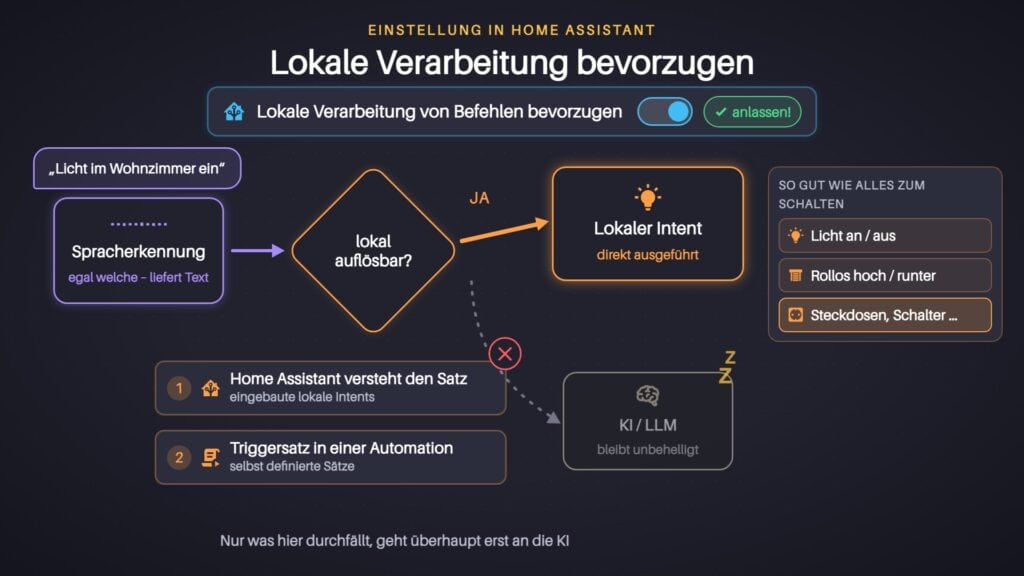
In der Assist-Pipeline gibt es die Option Lokale Verarbeitung bevorzugen (englisch „Prefer handling commands locally“). Damit versucht Home Assistant jeden Satz zuerst mit seinem eingebauten Satz-Matcher, und nur wenn der nichts findet, geht die Anfrage an das KI-Modell. Der Unterschied ist gewaltig:
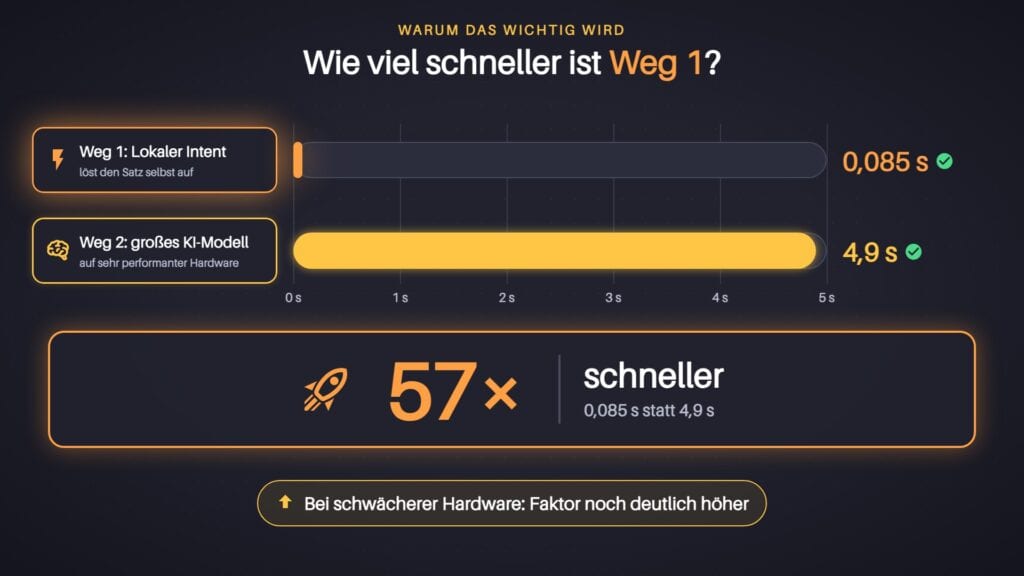
Faktor 57. Die KI ist also der Fallback für alles, was der Satz-Matcher nicht kennt, und nicht der Normalfall. „Licht im Studio aus“ darf nie an ein Sprachmodell gehen. Und das gilt nicht nur für die eingebauten Sätze: Auch Sätze, die du in deinen eigenen Automationen als Auslöser festlegst, werden so direkt und ohne KI verarbeitet. Genau darauf bauen meine Sprach-Automationen weiter unten auf.
Und was ist mit Speech-to-Phrase?
Speech-to-Phrase ist das offizielle Add-on für schwache Hardware. Es ersetzt Whisper, erkennt aber nur einen festen Katalog von Sätzen, den es aus deinen freigegebenen Geräten baut. Das dauert rund 0,2 Sekunden und läuft auch auf einem Raspberry Pi. Der Preis: kein Freitext. „Mach mal gemütlich“ oder „Wann hat der Wildtierpark offen?“ kann es prinzipbedingt nicht erkennen.
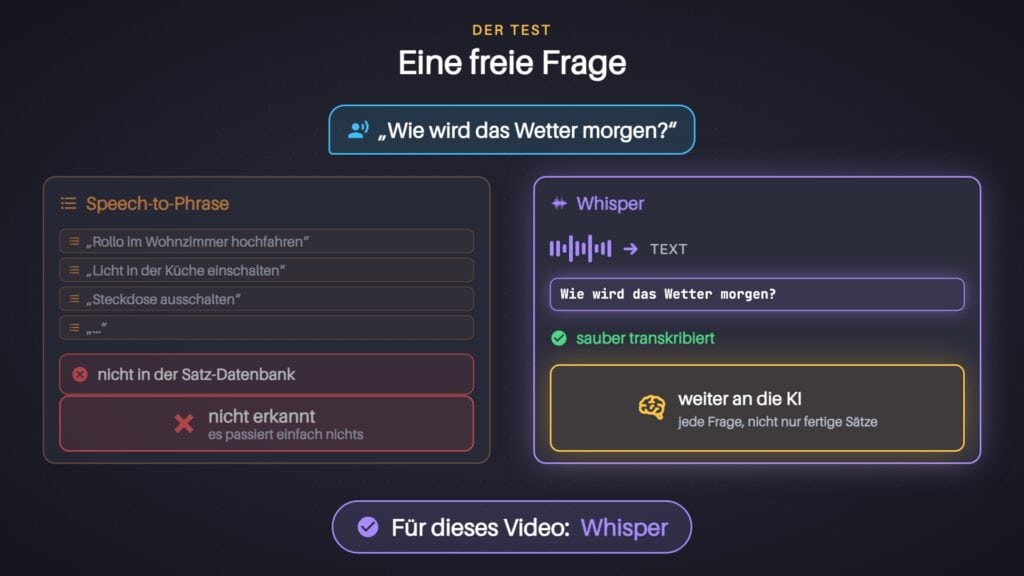
Nicht verwechseln: Das hat nichts mit „Lokale Verarbeitung bevorzugen“ zu tun. Speech-to-Phrase ersetzt die Spracherkennung (also Whisper), der Schalter entscheidet erst danach, wer den erkannten Text verarbeitet.
Wer nur Geräte schalten will und keine starke Hardware hat, ist damit gut bedient und ergänzt fehlende Sätze in der Datei /share/speech-to-phrase/custom_sentences/de/sentences.yaml. Daran ist nichts falsch. Ich habe es selbst eine Weile mit einem Proxy vor Whisper betrieben und bin davon abgerückt, weil mein Ziel ein Assistent mit dem Funktionsumfang von Alexa und Co. war. Dafür ist Whisper der Weg, deshalb kommt Speech-to-Phrase im Rest des Beitrags nicht mehr vor.
🎙️ Die Hardware zum Reinsprechen: Satelliten
Der Satellit ist das Gerät im Raum: Mikrofon, Wake-Word-Erkennung, Lautsprecher. Hier ein Überblick über alles, was ich selbst im Einsatz hatte. Wichtig für die Transparenz: Alle Satelliten habe ich von meinem eigenen Geld gekauft.
Home Assistant Voice Preview Edition
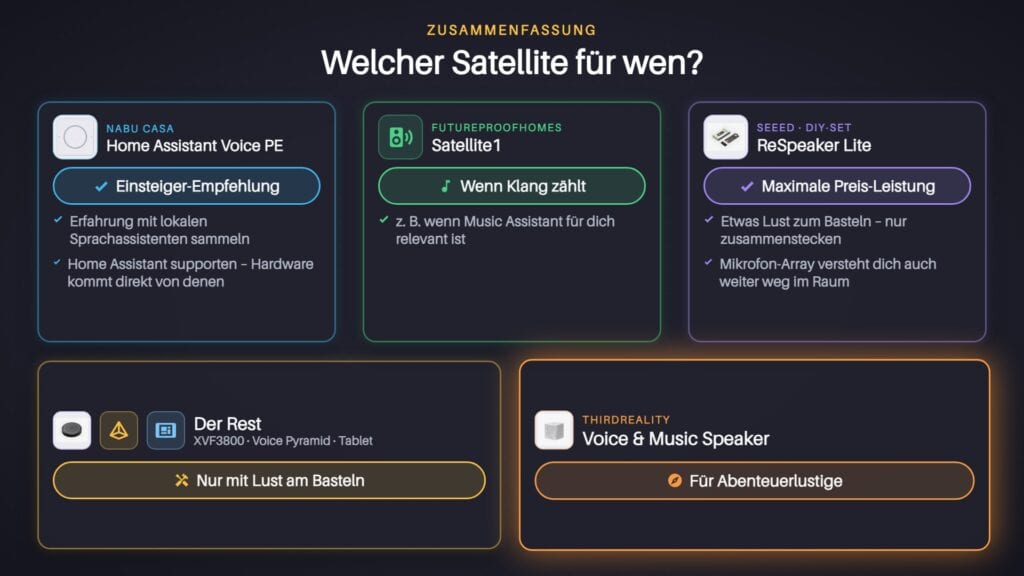
Die Referenz. Läuft stabil, wird direkt von Home Assistant erkannt, Wake Word funktioniert zuverlässig aus einigen Metern. Der Klang ist allerdings Küchenradio-Niveau. Für Ansagen völlig okay, für Musik nicht gedacht. Wer einfach anfangen will und nebenbei Home Assistant unterstützen möchte (die Hardware kommt direkt von dort), nimmt die.


FutureProofHomes Satellite 1
Mein aktueller Favorit. Bester Klang und beste Mikrofone in dieser Klasse, und man kann ihn komplett zusammengebaut kaufen, optional sogar mit einem Präsenzmelder, den man selbst ins Gehäuse setzt. Das nenne ich wirklich mal Future-Proof. Die Firmware ist noch jung, aber schon weit: In Version 0.2.0 gab es nach Sprachbefehlen ab und zu Abbrüche bei der Musikwiedergabe über Music Assistant (Sendspin). Mit der aktuellen 0.2.1-Beta habe ich keine Probleme mehr festgestellt.
🛒 Den Satellite 1 gibt es nicht bei Amazon, sondern nur direkt beim Hersteller: futureproofhomes.net. Dort bekommst du ihn fertig zusammengebaut (als Satellite1.1 Smart Speaker), daneben gibt es Dev-Kits und Einzelteile zum Selbstbauen.
ThirdReality Voice & Music Assistant
Guter Sound, besser als die Voice PE, aber kein Hi-Fi wie beim Satellite 1. Dazu ein paar Besonderheiten: Er ist komplett Linux-basiert, ESPHome gibt es hier also nicht, und die Firmware kannst du nicht selbst anpassen. Er kann kein USB-PD und braucht ein „dummes“ 5-Volt-Netzteil (liegt bei). An modernen USB-C-Ladegeräten bleibt er stromlos oder startet bei lauten Bässen neu. Und bei mir brach die Musikwiedergabe über Music Assistant ständig ab. Nach längerer Fehlersuche stellte sich heraus, dass die LED-Ring-Animation (eine sogenannte Visualizer-Rolle im Sendspin-Protokoll) den Client so ausbremst, dass der Server Audio-Pakete verwirft.
Mein Gerät hatte ich zurückgeschickt, weil es so nicht nutzbar war. Daumen hoch trotzdem an ThirdReality: Der Hersteller hat sich auf mein Feedback gemeldet, die Ursache bestätigt und arbeitet an der Lösung. Mit der neuesten Firmware soll das Problem nicht mehr auftreten. Wenn du ein bisschen abenteuerlustig bist, ist er damit eine Option.
DIY: ReSpeaker Lite, XVF3800, M5 Voice Pyramid
- ReSpeaker Lite: Super, es gibt tolle 3D-Druck-Gehäuse und fertige Bausätze. Mit dem Bausatz samt Lautsprecher klingt er etwa so gut wie der ThirdReality. Maßgebliche ESPHome-Konfiguration ist die von formatBCE, nicht die aus dem Seeed-Wiki (die scheitert an aktuellen ESPHome-Versionen). Spannende Idee, die ich selbst nicht getestet habe: Über den 3,5-mm-Audioausgang kannst du ihn in ein Deckengehäuse setzen und an echte Deckenlautsprecher hängen. Dann stimmt auch der Klang.
- ReSpeaker XVF3800: Von den Mikrofonen her das Beste, was ich hatte (vier Mikrofone im Array). Aber er ist teurer, es gibt kaum gute Gehäuse mit Lautsprecher, wenige 3D-Druck-Projekte und kein fertiges Set. Also nur etwas für richtig gute Bastler. Achtung beim Lautsprecher: 4 Ohm, nicht 8 Ohm, sonst ist es viel zu leise.
- M5 Voice Pyramid mit AtomS3R: Davon kann ich aktuell nur abraten (Stand September 2026). Die Firmware hat noch viele Probleme, bei mir lief sie nicht brauchbar. Dazu teilen sich Mikrofon und Lautsprecher einen I2S-Bus: Das Wake Word reagiert nicht, während Musik läuft, es gibt kein Barge-in und keine Echo-Unterdrückung. Und das USB-Kabel muss an die Pyramide, nicht an den Atom, sonst ist der Verstärker unterversorgt. Das steht leider nirgends in der Anleitung.


Tablet an der Wand als Satellit
Die Home-Assistant-App kann als experimentelles Feature Wake Word und Assist direkt auf einem Android-Tablet. Beispielsweise auf einem Nokia T20 lässt sich die App regulär als Standard-Assistent setzen. Auf dem Fire HD 10* blockiert Amazon das, es geht nur mit einem ADB-Trick (Alexa-Dienst deaktivieren, dann die drei Assistenten-Settings auf die HA-App setzen). Wichtig auf Fire-Tablets: die Minimal-APK ohne Google-Dienste nehmen, sonst kommen keine Push-Nachrichten an.
Erwartung: Das Fernfeld-Mikrofon eines Tablets ist deutlich schlechter als ein Mikrofon-Array. Nett, wenn man ohnehin davorsteht. Schlecht, wenn es dich nachts im Bett anquatscht.
Also ja, es geht. In der Praxis war der Arabella-hasst-mich-mal-wieder-Faktor aber hoch, weil beide Tablets nachts angefangen haben zu reden 😅 Für den Dauereinsatz kann ich das deshalb nicht empfehlen.
Kurzfazit Satelliten
- Einsteiger und „soll einfach gehen“: Voice PE
- Klang zählt, auch für Musik über Music Assistant: Satellite 1
- Lust am Basteln oder das meiste fürs Geld, mit einem Mikrofon-Array, das dich auch weiter weg im Raum versteht: ReSpeaker Lite
- Fertige Hardware für Abenteuerlustige: ThirdReality
- Aktuell nicht zu empfehlen: M5 Voice Pyramid und das Tablet als Dauerlösung
🖥️ Die Hardware zum Rechnen: Worauf die KI laufen muss
Das ist das Kernkapitel, und es beginnt mit der ehrlichsten Aussage des ganzen Beitrags: Wenn es performant laufen soll, wird es nicht billig. Egal welche der folgenden Varianten du nimmst.
Warum ich nur größere Modelle betrachte
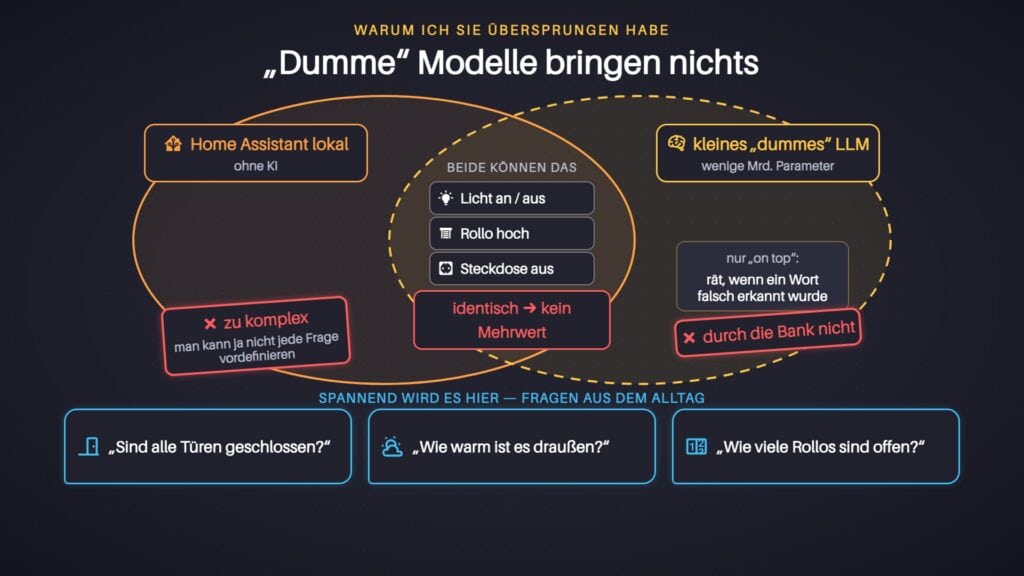
Es gibt natürlich deutlich kleinere, spezialisierte Modelle, die sogar auf derselben Hardware wie dein Home Assistant laufen würden, etwa als VM auf Proxmox. Die können aber im Wesentlichen nur Lichter schalten und Rollos fahren. Und genau das erledigt Home Assistant mit „Lokale Verarbeitung bevorzugen“ ohnehin selbst, ganz ohne KI. Für mich ist das kein Sprachassistent, sondern ein Sprachinterface für einen Schalter.
Spannend wird es erst bei Fragen wie „Sind alle Türen zu?“ oder „Wie viele Rollos sind noch offen?“. Daran sind in meinen Tests praktisch alle kleinen Modelle gescheitert, und Home Assistant allein kann das auch nicht, weil niemand jede denkbare Frage als Satz vordefinieren kann. Deshalb geht es hier nur um Modelle, die sich wirklich nach Assistent anfühlen. Das kostet leider Hardware.
Was die meisten tatsächlich machen: vorhandene Hardware
Der verbreitetste Weg ist gar kein Neukauf, sondern Hardware, die schon da ist: der Gaming-PC mit einer Grafikkarte mit 16 oder 24 GB Videospeicher, ein alter Server mit viel RAM, oder ein Mac mini beziehungsweise Mac Studio mit ordentlich Unified Memory. Wenn du so etwas hast, fang damit an. Die Regel weiter unten („Wie viel Speicher braucht das Modell?“) gilt für jede dieser Kisten genauso. Alles, was jetzt folgt, ist für den Fall, dass du dafür neu kaufen willst.
Raspberry Pi 5 mit AI HAT+ 2: Finger weg für Sprachsteuerung
Der AI HAT+ 2* mit dem Hailo-10H für den Raspberry Pi 5* klingt auf dem Papier perfekt: 40 TOPS, 8 GB eigener Speicher, Sprachmodelle direkt auf der NPU. In der Praxis rennt man gegen drei Wände. Der mitgelieferte Ollama-kompatible Server lehnt das Tools-Feld ab, das Home Assistant für die Gerätesteuerung braucht. Alle Modelle sind hardwareseitig auf 2.048 Token Kontext begrenzt, und Home Assistant schreibt allein für 200 freigegebene Geräte mehr als das in den System-Prompt. Und selbst mit radikal reduzierter Geräteliste liegt man bei rund 30 Sekunden pro Antwort. Das ist kein Sprachassistent, das ist ein Ladebildschirm.
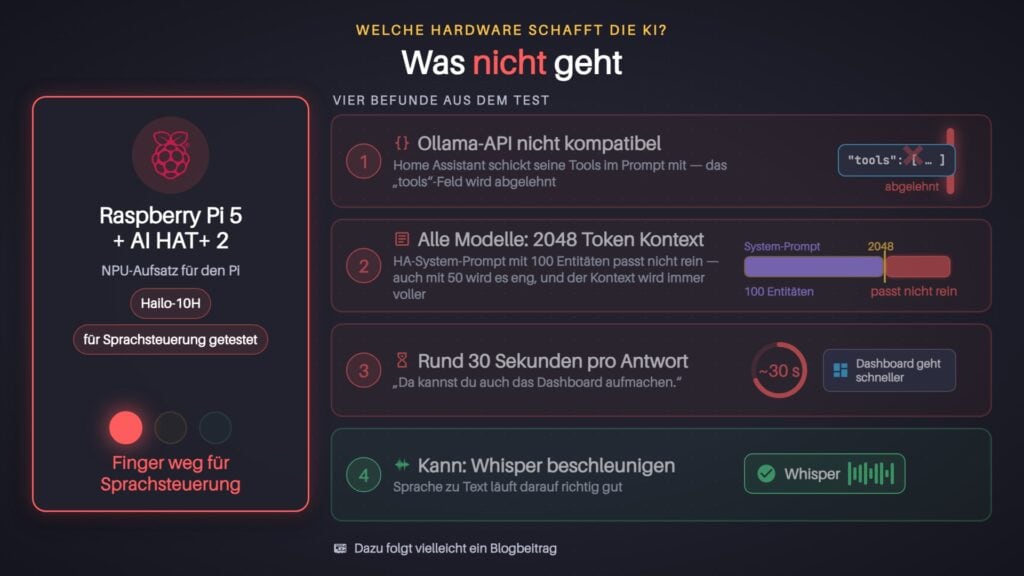
Was der Chip richtig gut kann: Whisper beschleunigen. Die komplette Bilanz inklusive Installationsanleitung steht in einem eigenen Beitrag:
📖 Raspberry Pi 5 AI HAT+ 2 für Home Assistant Sprachsteuerung: https://www.simon42.com/?p=25415 (wird in Kürze veröffentlicht)
Hinweis zu GMKtec
GMKtec hat mir die beiden folgenden Rechner für diesen Test zur Verfügung gestellt, und ich schicke sie danach wieder zurück, leider 😅. Es gab keine Bedingungen: kein Video, kein Blogbeitrag, nicht einmal eine Erwähnung. Die Firma hatte sich nach meinem Interview mit dem Shelly-CEO gemeldet und gefragt, ob ich mir ihre Mini-PCs anschauen und Feedback geben möchte.
Ich wollte dir das im Sinne der Transparenz mitteilen und mich bei GMKtec bedanken, denn ohne diese Test-Hardware hätte ich nie so viele Modelle testen können.
16-GB-Mini-PC (Intel Lunar Lake)
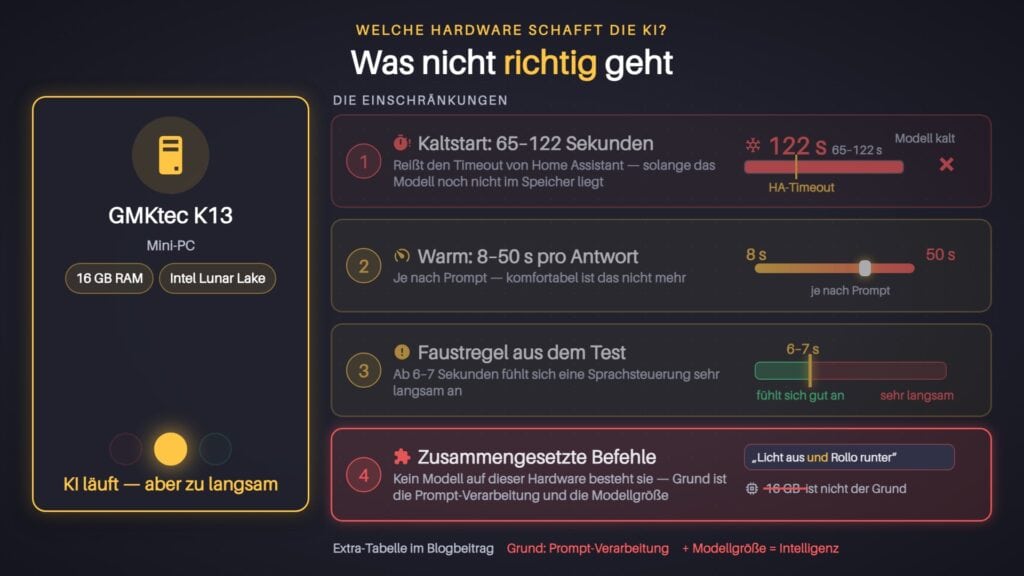
Getestet habe ich einen GMKtec K13 mit Core Ultra 7 256V, Arc 140V und 16 GB RAM, von denen rund 11,5 GB für die Grafikeinheit nutzbar sind. Es läuft. Aber die Zahlen mit einem realistischen Prompt (rund 6.500 Token, entspricht meiner Home-Assistant-Installation) sind ernüchternd:
| Modell | Speicher | Kaltstart | Antwort warm | Tokens/s |
|---|---|---|---|---|
| qwen3:4b-instruct-2507 | 3,9 GB | 101 s | 8,6 s | 13,0 |
| gemma4:e4b | 3,3 GB | 108 s | 9,9 s | 11,1 |
| lfm2.5:8b | 5,4 GB | 65 s | 29,9 s | 28,8 |
| gemma4:12b-it-qat | 8,0 GB | 122 s | 49,7 s | 3,1 |
Der Kaltstart reißt jedes Mal den 60-Sekunden-Timeout von Home Assistant (kann man auch nicht ändern). Auf 16 GB ist keep_alive: -1 (Modell dauerhaft im Speicher halten) deshalb keine Optimierung, sondern Voraussetzung. Und kein Modell dieser Klasse besteht zusammengesetzte Befehle wie „alle Lichter aus außer im Büro“ zuverlässig. Zur Einordnung: Alles, was länger als 6 bis 7 Sekunden dauert, fühlt sich bei Sprachsteuerung schon sehr zäh an.
Der eigentliche Grund ist nicht der Speicher, sondern die Prompt-Verarbeitung: Die Arc 140V schafft beim Einlesen des Prompts rund 29 Token pro Sekunde, der große Rechner unten rund 1.000. Faktor 35. Bei 6.500 Token Prompt ist das der Unterschied zwischen „sofort“ und „geh dir einen Kaffee holen“.
Ryzen AI Max+ 395 mit 128 GB
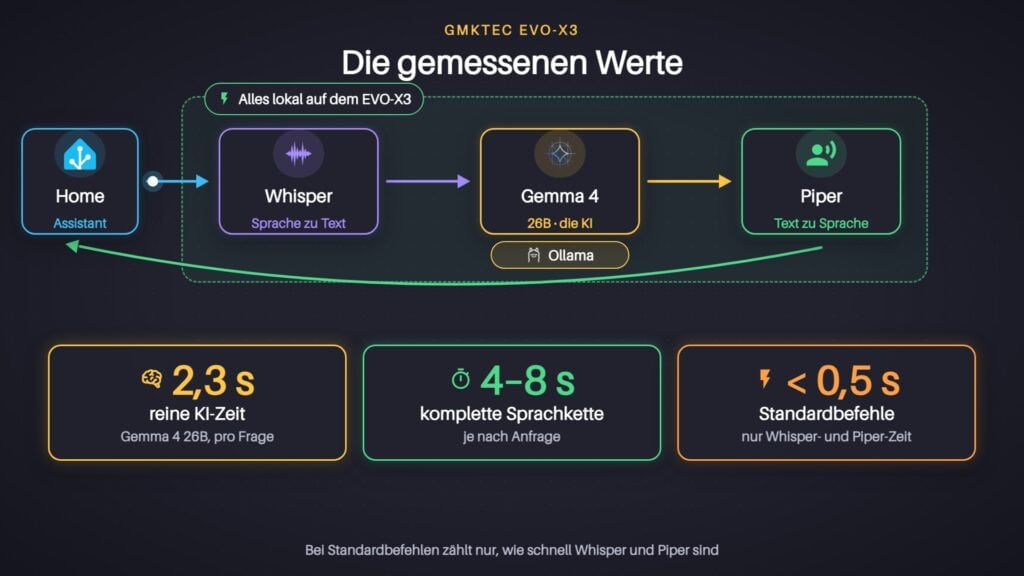
Mein Hauptsystem für diesen Test ist ein GMKtec EVO-X3 mit AMD Ryzen AI Max+ 395 („Strix Halo“), Radeon 8060S und 128 GB Unified Memory, aktuell rund 3.500 Euro. Der Witz an dieser Plattform: CPU und Grafikeinheit teilen sich den kompletten Arbeitsspeicher mit sehr breiter Anbindung, ähnlich wie Apple Silicon das macht. Genau das braucht ein Sprachmodell, denn die Inferenz ist speicherbandbreiten-limitiert, nicht rechenlimitiert.
Damit antwortet gemma4:26b in durchschnittlich 2,35 Sekunden reiner KI-Zeit pro Frage, gemessen über sechs Alltagsfragen gegen meine echte Installation. Die komplette Sprachkette (Whisper, KI, Piper) liegt bei komplexen Fragen bei 5 bis 9 Sekunden, Standardbefehle über den lokalen Intent bleiben unter einer Sekunde.
Setup-Stolpersteine auf dieser Plattform, damit du sie nicht neu entdecken musst: Ubuntu 24.04 braucht den HWE-Kernel 7.0 (6.8 kennt Strix Halo nicht). Der Nutzer und der Ollama-Dienst müssen in der Gruppe render sein, sonst rechnet Vulkan in Software. Und Vulkan schlägt ROCm bei MoE-Modellen deutlich, deshalb OLLAMA_LLM_LIBRARY=vulkan.


Aber: Wie viel Speicher braucht das Modell wirklich?
Zwischen 16 GB und 128 GB liegt eine Menge. Statt ein konkretes Gerät zu empfehlen, das nächsten Monat schon wieder anders heißt, hier die Rechnung für mein Produktivmodell gemma4:26b, damit du jede Kiste selbst bewerten kannst:
| Posten | Speicher |
|---|---|
| Modellgewichte gemma4:26b (Q4_K_M) | 17 GB |
| Kontext-Cache bei 8k bis 16k Token | 2 bis 3 GB |
| Voller SWA-Cache (siehe Setup, nur Gemma) | 2,8 GB |
| Summe GPU-adressierbar | rund 23 bis 25 GB |
| Whisper + Piper (laufen auf der CPU) | 2 bis 4 GB RAM, mehrere Kerne |
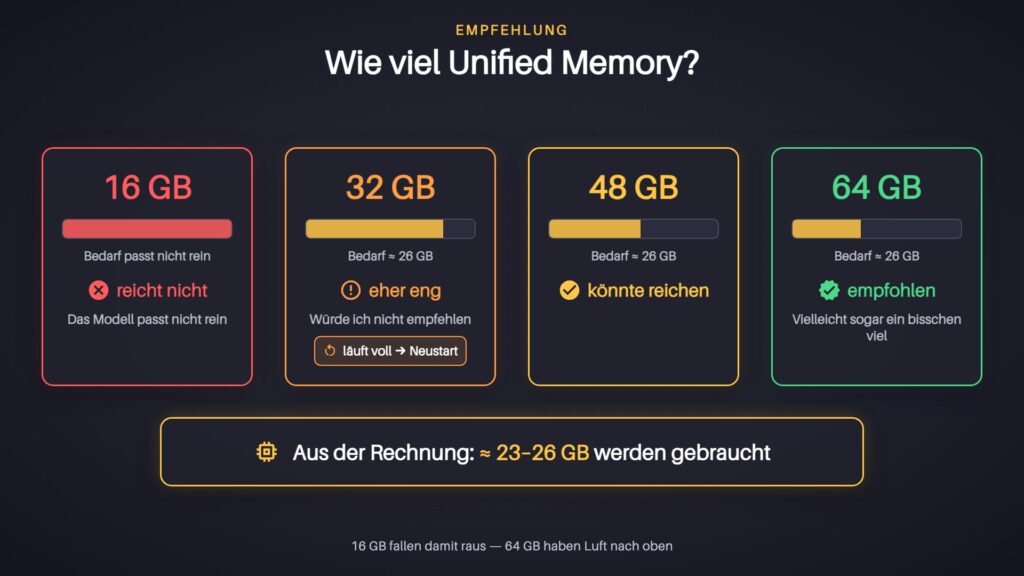
Daraus folgt die Ausstattungsregel: Mindestens 32 GB Unified Memory oder eine Grafikkarte mit 24 GB Videospeicher, besser 48 bis 64 GB Unified Memory, damit auch das Bildmodell für KI-Aufgaben parallel warm bleiben kann. 16 GB reichen nicht, egal wie schnell der Chip ist. Konkrete Kandidaten, Stand September 2026:
| Option | Speicher | Preis (ca.) | Anmerkung |
|---|---|---|---|
| GMKtec EVO-X2, Ryzen AI Max+ 395 | 64 GB | 1.960 € | Gleiche Plattform wie mein EVO-X3, halber Speicher, reicht für gemma4:26b locker |
| Framework Desktop, Ryzen AI Max+ 395 | 64 GB | ca. 1.640 $ | Gleicher Chip, modular, Preise wegen RAM-Krise gestiegen |
| Mac mini M5 Pro | 64 GB | Mac Mini M5 Pro* | Ollama läuft nativ auf Apple Silicon, Whisper und Piper ebenfalls; nicht selbst getestet, zu teuer 😅 |
| PC mit gebrauchter RTX 3090 | 24 GB VRAM | Karte 500 bis 950 € | Knapp, aber NVIDIA hat beim STT den Vorteil: Whisper läuft dort auf der GPU in unter 1 s. 300 bis 350 W unter Last |
| Mac Studio M1 Max, gebraucht | 32 GB | 1.200 bis 1.600 € | „Günstigster“ Einstieg mit genug Speicher. 400 GB/s Speicherbandbreite, also auf dem Papier schneller pro Token als mein EVO-X3. Nicht selbst getestet |
| Mac Studio M1 Max, gebraucht | 64 GB | 2.150 bis 2.650 € | Platz für Sprach- und Bildmodell gleichzeitig. Ab hier ist die neue 64-GB-Strix-Halo-Kiste günstiger |
| Mac Studio M2 Max, gebraucht | 32 GB | 1.450 bis 1.900 € | Wie M1 Max, etwas schneller |
| Mac mini M4 Pro, gebraucht | 48 GB | 2.600 bis 3.200 € | Wegen der RAM-Krise aktuell teurer als ein neuer EVO-X2. Lohnt sich nicht |
Die Gebrauchtpreise sind Angebotspreise auf Kleinanzeigen im September 2026, Verhandlungsbasis inklusive. Der gebrauchte Mac mini ist keine Sparoption mehr, seit Apple die Preise wegen der RAM-Krise angehoben hat.
Meine Einschätzung: Sich so eine Kiste nur für lokale KI anzuschaffen, dafür muss dein Haus schon sehr sensible Daten haben, oder du hast echt viel Geld übrig. Spaß beiseite: Nur für einen lokalen Sprachassistenten halte ich das für Overkill. Zum Experimentieren mit lokaler KI allgemein sehe ich das schon eher 👍

💰 Die Gegenrechnung: Was kostet dasselbe in der Cloud?
Bevor du 2.000 Euro ausgibst, gehört die ehrliche Gegenrechnung dazu. Die aus meiner Sicht einzige ernsthafte Cloud-Alternative für ein deutsches Smart Home, bei der mich die datenschutzbewussten Mitleser nicht gleich aufhängen, ist Mistral: europäischer Anbieter, EU-Inferenz-Endpunkte, DSGVO-tauglich. Für Home Assistant gibt es die HACS-Integration HA_MistralAI. Sie unterstützt die Assist-Steuerung, Voxtral für Sprache-zu-Text und Mistral-TTS für die Sprachausgabe.
Rechenannahmen: 30 Anfragen pro Tag (das ist vermutlich hoch gegriffen), ein Prompt mit rund 9.000 Token wie in meiner Installation, zwei Runden pro Anfrage (Werkzeug aufrufen, dann antworten, also rund 20.000 Eingabe-Token), 150 Ausgabe-Token, dazu 5 Sekunden Audio pro Anfrage und 100 Zeichen Sprachausgabe. Preise laut Mistral-Preisliste, Stand September 2026, ohne Prompt-Caching:
| Modell | Preis Eingabe / Ausgabe pro 1 Mio. Token | Kosten pro Jahr (nur Sprachmodell) |
|---|---|---|
| ministral-8b-latest (Standard der Integration) | 0,15 $ / 0,15 $ | ca. 33 $ |
| mistral-small-latest (Small 4) | 0,15 $ / 0,60 $ | ca. 34 $ |
| mistral-large-latest (Large 3) | 0,50 $ / 1,50 $ | ca. 112 $ |
| mistral-medium-latest (Medium 3.5) | 1,50 $ / 7,50 $ | ca. 340 $ |
Dazu kommen Voxtral für die Transkription (0,003 $ pro Audiominute, rund 3 $ im Jahr) und die Sprachausgabe (0,016 $ pro 1.000 Zeichen, rund 18 $ im Jahr). Zusammen landest du mit dem Standardmodell bei rund 50 Dollar im Jahr, mit dem großen Modell bei rund 130. Wer die Geräteliste auf 50 Entitäten eindampft, drittelt die Eingabe-Token und damit den Löwenanteil.
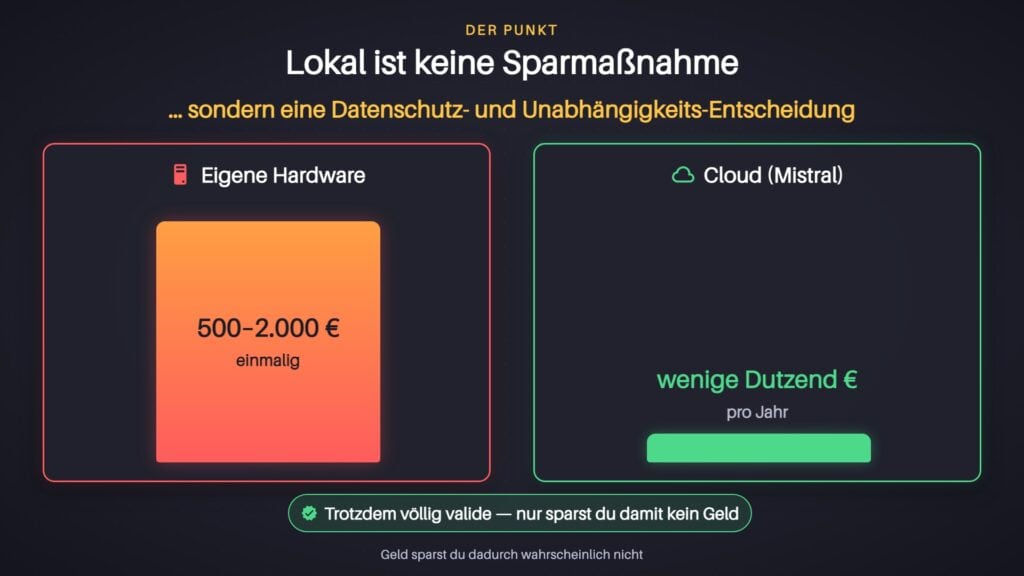
Die Schlussfolgerung ist unbequem, aber klar: Lokal ist keine Sparmaßnahme. Ein 2.000-Euro-Rechner amortisiert sich gegen die Mistral-Cloud vermutlich nie, schon gar nicht mit Stromverbrauch. Und weil sich die Modelle so schnell weiterentwickeln, brauchst du für aktuelle Modelle in zwei Jahren vielleicht schon wieder andere Hardware.
Lokal ist eine Entscheidung für Datenschutz, Unabhängigkeit und dafür, dass niemand außer dir bestimmt, was der Assistent morgen noch kann. Wenn dir das egal ist, ist Mistral in der Cloud der günstigere und bequemere Weg. Und das sage ich als jemand, der es wirklich lange eingerichtet hat 🙈
🧠 Die Modelle: 25 getestet, drei bleiben
Die eine Regel zur Modellwahl aus meinen Tests
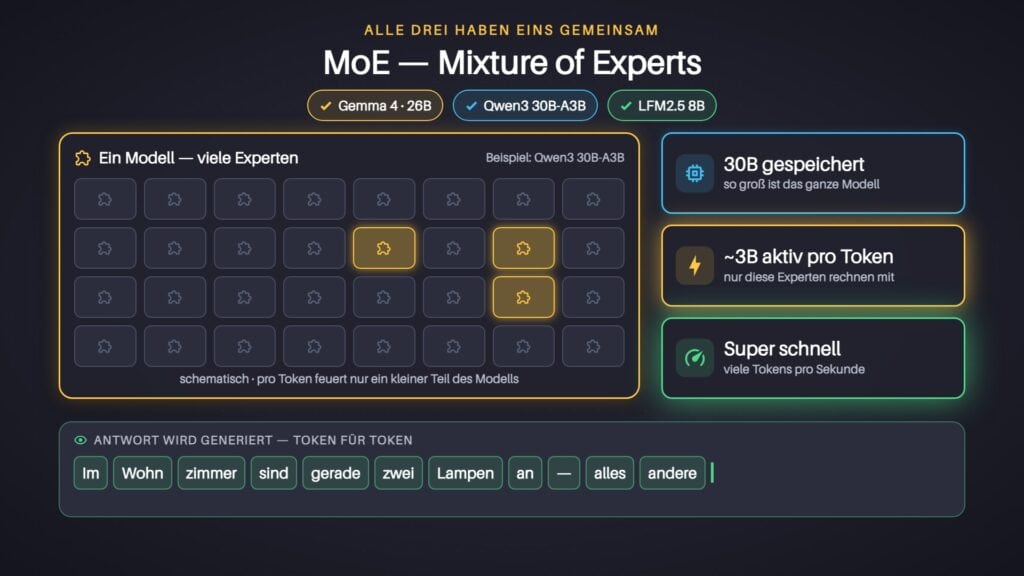
Es zählen die aktiven Parameter, nicht die Gesamtgröße. Bei „Mixture of Experts“-Modellen (MoE) stehen zwar 26 oder 30 Milliarden Parameter auf der Platte, pro Token rechnen aber nur 3 bis 4 Milliarden davon. Weil die Inferenz am Speicherdurchsatz hängt, ist ein 30B-MoE mit 3B aktiv schneller als ein dichtes 8B-Modell. Bei Qwen steht das im Namen (30b-a3b), bei Gemma nur im vollständigen Tag-Namen (gemma4:26b-a4b). Wie groß der Effekt ist, zeigt die Tabelle unten: Qwen mit 30 Milliarden gespeichert und 3 aktiv schafft 95 Tokens pro Sekunde, Granite mit 30 Milliarden und dichtem Verhalten nur 12. Gleiche Größe, siebenfacher Unterschied.
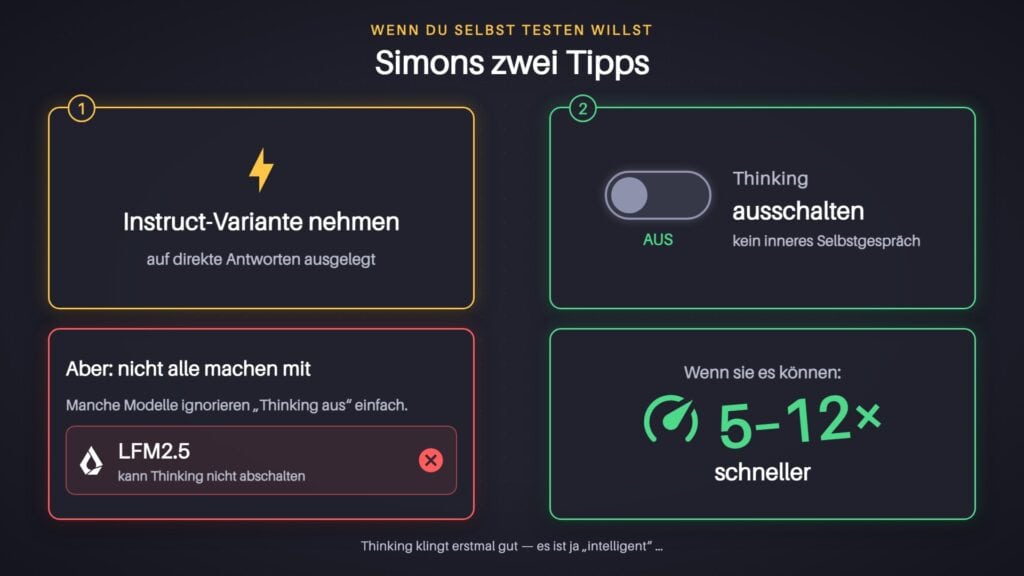
Zweite Regel: Thinking-Modelle sind für Sprachsteuerung Gift. Ein Thinking-Modell führt vor jeder Antwort erst einen inneren Monolog („Der Nutzer möchte, dass ich die Rollos hochfahre. Habe ich ein Werkzeug dafür? Ich prüfe mal …“). Den hörst du nicht, aber er muss trotzdem komplett generiert werden. qwen3.6 braucht so 416 Token für einen Satz, der Vorgänger 2507 nur 38. Deshalb: Instruct-Varianten nehmen und Thinking ausschalten, wo das Modell es zulässt. Das macht die Antwort fünf- bis zwölfmal schneller.
Und nicht jede neue Generation ist ein Fortschritt: Qwen 3.5 und 3.6 haben die Instruct-Variante gestrichen und sind für diesen Zweck schlechter als das ältere qwen3:30b-a3b-instruct-2507.
Die große Vergleichstabelle
Ein Modell pro Zeile, sortiert nach meinem Urteil, nicht nach Tempo. Ein Strich heißt: in dieser Messreihe nicht getestet. Die Spalten im Einzelnen:
- Tempo ist die Generierung in Tokens pro Sekunde auf dem EVO-X3 (Vulkan, kurzer Prompt, Median aus drei Läufen).
- Assist-Test sind vier Standardaufgaben auf einer Test-Instanz mit fünf Lichtern und einem Temperatursensor in vier Bereichen: „Licht im Wohnzimmer aus“, „Wie warm ist es im Schlafzimmer?“, „Alle Lichter aus außer im Büro“, „Mach mal gemütlich“, Kontext 8k; die Zeit ist die komplette Antwort bei geladenem Modell.
- Praxis-Serie sind Alltagsfragen gegen meine echte Installation mit 204 freigegebenen Entitäten (Rollos im Studio offen oder zu, Lichter zählen, welche Rollos geschlossen sind, Wetter nächste Woche, Öffnungszeiten des Wildtierparks), Zeit ist die reine KI-Zeit aus dem Ollama-Log.
- 16 GB ist die Antwortzeit auf dem GMKtec K13 mit realistischem 6.500-Token-Prompt.
| Modell | Typ / aktiv | Größe | Tempo X3 | Assist-Test X3 | Praxis-Serie X3 | 16 GB | Bilder | Urteil |
|---|---|---|---|---|---|---|---|---|
| gemma4:26b | MoE, ~4B | 17 GB | 62 t/s | 4/4, 16 bis 22 s | 2,35 s, 4/5 | passt nicht | ✅ | Mein Praxissieger. Sauberstes Deutsch, extrem prompt-treu, bedient auch KI-Aufgaben mit Bildern |
| qwen3:30b-a3b-instruct-2507 | MoE, ~3B | 20 GB | 95 t/s | 4/4, 11 bis 19 s | 2,69 s, 3/5 | passt nicht | ❌ | Schnellster unter den Großen, aber zwei Ausfälle in der Praxis (wirre Aufzählung, einmal keine Antwort) |
| gemma4:12b-it-qat | dense | 7,2 GB | – | – | 4,22 s, 4 bis 5/5 | 49,7 s | ✅ | Genauigkeitssieger (nennt als Einziges alle geschlossenen Rollos), aber dense: auf 16 GB zu langsam |
| gemma4:12b | dense | 7,6 GB | 27 t/s | 4/4, 24 bis 29 s | – | ca. 89 s (CPU-Split) | ✅ | Solide, behauptet aber zu „dimmen“ bei An/Aus-Lampen. QAT-Fassung vorziehen |
| lfm2.5:8b | MoE, ~1,5B | 5,2 GB | 153 t/s | 3,5/4, 3 bis 4 s | – | 29,9 s | ❌ | Tempokrone und löst die Ausnahme-Logik, denkt aber 275 Token pro Satz; auf 16 GB frisst das den Vorteil auf |
| glm-4.7-flash | MoE | – | 66 t/s | 3,5/4, 13 bis 19 s | – | – | ❌ | Ausnahme-Logik korrekt, schmückt aus und gibt Markdown-Sterne mit aus (Sehr nervig bei TTS) |
| qwen3.5:9b | dense | – | – | 3,5/4, 16 bis 22 s | – | passt nicht (CPU-Split) | ❌ | Erstes Modell unter 12B, das „alle außer“ besteht. Läuft auf 16 GB aber nicht sauber |
| qwen3.6:35b-a3b | MoE, ~3B, Thinking | – | 69 t/s | – | 4,26 s, 3,5/5 | – | ❌ | 416 Token für einen Satz. Neuer, aber für Sprache schlechter als der 2507-Vorgänger |
| gpt-oss:20b | MoE, ~3,6B | 13 GB | 53 t/s | – | – | – | ❌ | Sauberes Deutsch, kein sichtbarer Denkblock, aber langsamer als Qwen |
| gemma4:e4b | MatFormer | 3,3 GB | – | – | – | 9,9 s | ✅ | Sparsamster Kandidat für 16 GB, einziger dort mit Bildfähigkeit. Nach Prompt-Korrektur sauberes Deutsch |
| qwen3:4b-instruct-2507 | dense | 3,9 GB | – | – | – | 8,6 s, 1,5/4 | ❌ | Schnellster auf 16 GB, aber unter der Logik-Wand: Bereiche nur teilweise, konfabuliert |
| qwen3:8b | dense | 5,2 GB | 40 t/s | 2/4, 13 bis 21 s | – | 2/4, 20 bis 26 s | ❌ | Invertiert „alle außer“. Identische Fehler auf beiden Rechnern |
| llama3.2:3b | dense | 2,0 GB | 81 t/s | 2/4, 3 bis 5 s* | – | – | ❌ | Einzelbefehl und Abfrage korrekt, verweigert „alle außer“ komplett, spricht bei „gemütlich“ rohes JSON vor |
| llama3.1:8b | dense | 4,9 GB | 46 t/s | 1,5/4 | – | – | ❌ | Meldet Vollzug ohne Aktion. Die 2024er-Standardempfehlung ist abgehängt |
| phi4-mini | dense, 3,8B | 2,5 GB | – | 0/4, unter 1 s* | – | – | ❌ | Ruft kein einziges Werkzeug auf: spricht den Werkzeugaufruf als Text vor, liest bei der Temperaturfrage die Werkzeugdefinition vor, behauptet bei „gemütlich“ eine Aktion, die nie passiert ist |
| lfm2:24b-a2b | MoE, ~2B | 14 GB | 125 t/s | – | 4,15 s, 2,5/5 | – | ❌ | Invertiert die Ausnahme-Logik, ruft zehnmal das falsche Werkzeug, Markdown und Emojis in der Sprachantwort |
| mistral-small3.2 | dense, 24B | – | 16 t/s | 1/4 | – | – | ✅ | „Entschuldigung, Fehler“-Schleife, kommt mit dem Werkzeug-Format nicht klar |
| granite4.1:30b | „MoE“, verhält sich dense | 22 GB | 12 t/s | – | – | – | ❌ | Siebenmal langsamer als Qwen bei gleicher Größe |
| nemotron-3.5-lightning | „3B aktiv“ laut Anbieter | – | 10 t/s | – | – | – | ❌ | Tempo eines dichten 32B-Modells, Herstellerangabe nicht belastbar |
| gpt-oss:120b | MoE | 65 GB | 38 t/s | – | – | – | ❌ | Läuft nur wegen 128 GB, für Sprache unnötig |
| llama3.3:70b | dense | – | 5 t/s | – | – | – | ❌ | Unbenutzbar langsam |
| functiongemma:270m | dense | 0,3 GB | – | 0/2 | – | – | ❌ | Verweigert alles, erwartet ein eigenes Prompt-Format |
* Nachgetestet am 8. September 2026 mit dem aktuellen Prompt; die Zeit ist hier die reine KI-Zeit aus dem Ollama-Log, nicht die komplette Assist-Antwort.
Was aus der Tabelle folgt
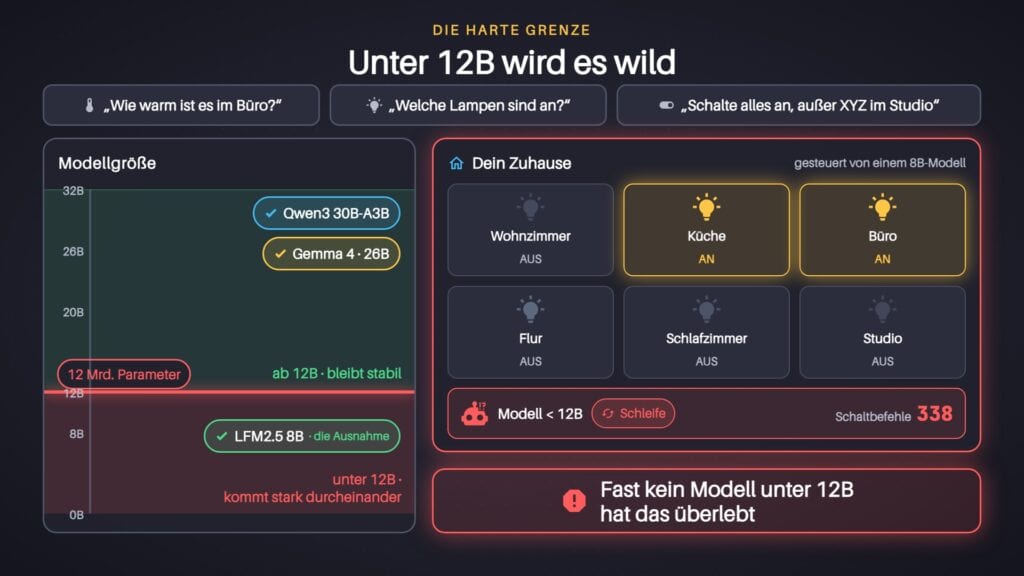
- Die Logik-Wand liegt zwischen 4 und 9 Milliarden Parametern. „Alle Lichter aus, außer im Büro“ besteht kein 3B- oder 4B-Modell (llama3.2 verweigert, phi4-mini führt gar nichts aus, qwen3:4b konfabuliert), qwen3.5:9b ist das erste, das es schafft. Einzelbefehle und einfache Abfragen können dagegen schon die Kleinen.
- Fehler sind modellbedingt, nicht hardwarebedingt. qwen3:8b macht auf dem 128-GB-Rechner exakt dieselben Fehler wie auf dem 16-GB-Rechner. Schnellere Hardware macht ein Modell nicht klüger, nur schneller falsch.
- Auf 16 GB besteht kein Modell zusammengesetzte Befehle. Einzelbefehle und Abfragen gehen dort in 8 bis 40 Sekunden. Bei komplexen Befehlen dauert es schlicht zu lange.
- Erst die Konfiguration prüfen, dann urteilen. Ein einziger Konfigurationsfehler kann ein Modell komplett disqualifizieren. lfm2.5 sah in einer ganzen Serie unbrauchbar aus, weil
think: falsebei diesem Modell den Denkblock nicht abschaltet, sondern nur die Trennung, sodass er mitten in der Sprachantwort landete. Gemma 4 war zwei Tage träge, bis der SWA-Cache-Schalter Faktor 2,6 brachte (ohne ihn lagen die beiden Gemmas in der Praxis-Serie bei 6,17 und 11,05 statt 2,35 und 4,22 Sekunden). Zwei Tage Host-Tuning (IOMMU aus, CPU-Governor) brachten dagegen zusammen nur 6 Prozent. - Die Lichter-Zählfrage taugt als Stresstest, nicht als Ausschlusskriterium. Außer den großen Modellen beantwortet keins zuverlässig, wie viele Lichter in der ganzen Wohnung eingeschaltet sind, und dieselben Modelle liefern in zwei Durchgängen verschiedene Zahlen.
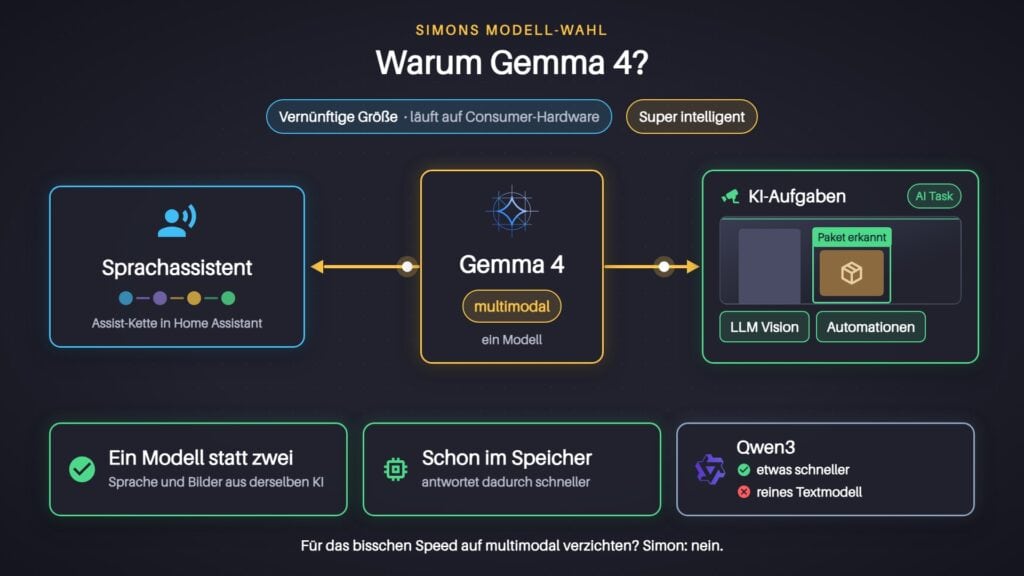
Die drei Sieger
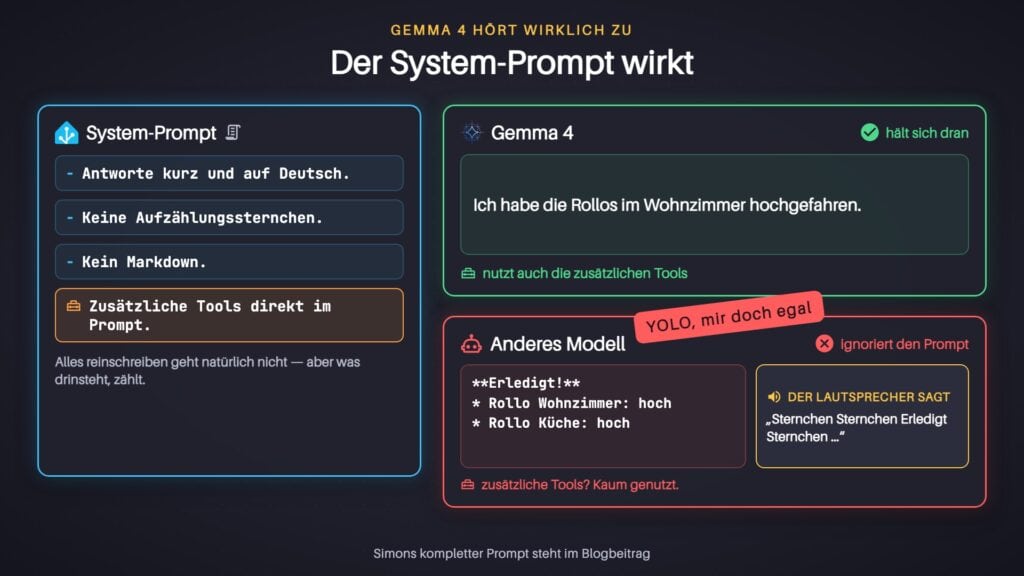
- gemma4:26b: mein Praxissieger. Eine Größe, die noch auf Consumer-Hardware passt, sehr intelligent, sauberstes Deutsch. Und es ist das prompt-treueste Modell im Test: Steht im System-Prompt „keine Aufzählungszeichen, kein Markdown“, hält es sich daran, und zusätzliche Werkzeuge aus dem Prompt nutzt es zuverlässig. Andere Modelle ignorieren so etwas teils komplett. Dazu ist es multimodal: Dasselbe Modell bedient bei mir auch die KI-Aufgaben in Home Assistant, etwa die Bildanalyse für die LLM-Vision-Timeline meiner Kameras oder Automationen, die ein Kamerabild auswerten. Ein Modell für beides, dauerhaft warm im Speicher.
- qwen3:30b-a3b-instruct-2507: Tempo mit Wissen. Das schnellste Modell, das bei mir trotzdem intelligent geantwortet hat, 4/4 im Test. In der Praxis-Serie kam es zweimal durcheinander (wirre Aufzählung, einmal gar keine Antwort nach dem Werkzeugaufruf). Es ist ein reines Textmodell, für Sprache allein aber ein sehr guter Kandidat. Subjektiv fühlte es sich für mich sogar einen Tick schneller an als Gemma 😅
- lfm2.5:8b: die kleinste Hardware. 5,2 GB, läuft auf 16 GB, ist sehr schnell und löst die Ausnahme-Logik. Aber es denkt 275 Token pro Satz, und Thinking lässt sich bei diesem Modell nicht abschalten.
Warnung zur QAT-Variante: Von gemma4:26b gibt es eine „quantisierungsbewusst trainierte“ Fassung gemma4:26b-a4b-it-qat. Sie ist 4 bis 6 Prozent schneller (rund 0,1 Sekunden) und 2 GB kleiner, hat bei mir aber in 2 von 14 Anfragen kaputte Werkzeugaufrufe produziert (Argumente ohne Anführungszeichen, Ollamas Parser wirft sie weg, Home Assistant meldet „Unable to get response“). Die normale Fassung: 0 von 13. Nimm das normale gemma4:26b.
Die Messung dazu, gleicher Agent, gleicher Prompt, Thinking aus, Kontext 16k, Median aus drei Läufen über die Assist-Pipeline:
| Testfall | gemma4:26b-a4b-it-qat (15 GB) | gemma4:26b Q4_K_M (17 GB) |
|---|---|---|
| Zustandsfrage Rollos | 1,77 s | 1,75 s |
| Lichter zählen | 3,00 s | 3,14 s |
| Aktion Studio-Rollo | 1,67 s | 1,77 s |
| Smalltalk | 0,75 s | 0,79 s |
| Kaltladen | 13,4 s | 14,1 s |
| Fehlversuche | 2 von 14 | 0 von 13 |
Was ist mit den fertigen Home-Assistant-Modellen?
Auf Hugging Face gibt es ein gutes Dutzend Modelle, die speziell auf Home Assistant trainiert wurden. Ich habe zehn davon getestet. Kurzfassung:
- Befehle makellos, oft in unter einer Sekunde, selbst auf dem 16-GB-Rechner.
- Aber praktisch alle scheitern an Zustandsfragen wie „Sind die Rollos im Studio offen?“ und erfinden lieber eine Antwort. Dazu ist keins davon offiziell auf Deutsch trainiert, viele antworten stur auf Englisch.
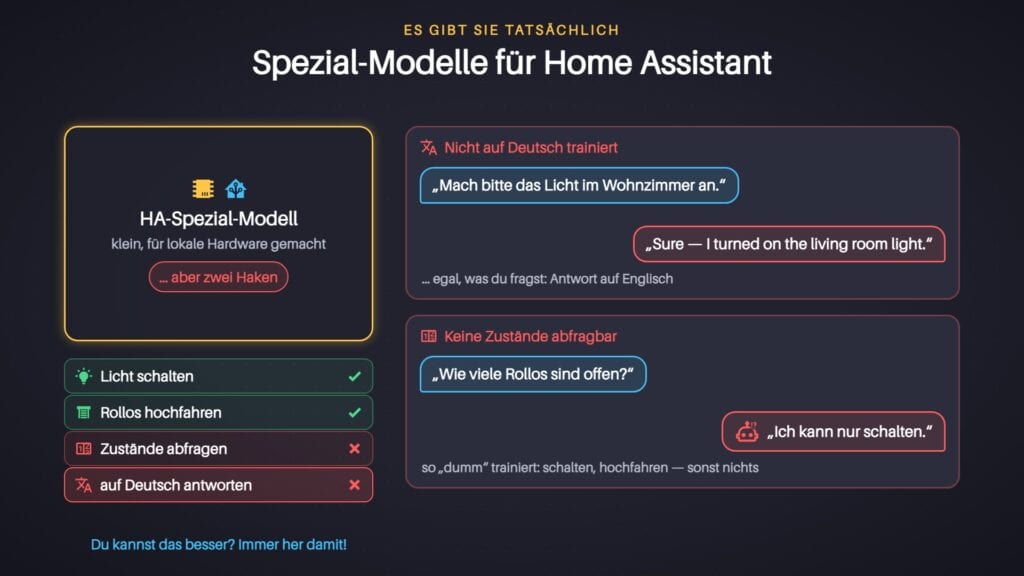
Der Grund ist der Datensatz, auf den sie alle zurückgehen: Er besteht zu 95 Prozent aus Befehlen. Nicht weil die Modelle zu klein sind, sondern weil es ihnen nie jemand beigebracht hat. Zur Einordnung: Home-Llama-3.2-3B antwortet auf dem EVO-X3 in 0,22 bis 0,48 Sekunden und auf dem 16-GB-Rechner in unter 2,3 Sekunden, die beiden Gemma-4-E2B-Spezialisten baxy und trusty in rund 2 Sekunden mit realistischem Prompt, also viermal schneller als das beste Allzweckmodell auf derselben Hardware.
Für schwache Hardware sind sie deshalb trotzdem interessant. Alle drei erfinden aber Zustände, wenn ihnen der Kontext fehlt, und alles abseits der reinen Steuerung ist eine Katastrophe. Das drückt bei mir den WAF leider zu sehr nach unten 😅
🛠️ Mein Setup zum Nachbauen
Vorweg: Das ist keine Anleitung mit Erfolgsgarantie, dafür ändert sich bei lokaler KI zu viel zu schnell. Es ist meine Konfiguration als Startpunkt für alle, die sich ein bisschen auskennen.
Architektur: Die komplette Sprachkette läuft als Docker-Container auf dem KI-Rechner. Home Assistant orchestriert nur. Alle Beispiele gehen von Ubuntu 24.04 auf dem KI-Rechner mit der IP 192.168.0.70 aus, das musst du anpassen.
Hinweis: Das meiste gibts auch als Addon auf Home Assistant. Aber auf KI-Hardware ist meist dann Whisper und Piper das kleinere Problem noch mit unter zu bringen und weil die Kisten so schnell sind, macht das dann mehr sinn 😉
1. Whisper (Sprache-zu-Text)
Whisper läuft auf der CPU, weil faster-whisper weder AMD- noch Intel-Grafik kann. Zwei Einstellungen machen den Unterschied: int8 statt float32 und 16 Threads statt der Standard-4. Damit transkribiert der EVO-X3 einen 4-Sekunden-Befehl in 1,26 Sekunden (vorher 2,1). Das Modell large-v3-turbo ist die richtige Wahl: Ein deutsches Fine-Tune brachte weder Tempo noch bessere Erkennung.
docker run -d --name wyoming-whisper --restart unless-stopped \
  -p 10300:10300 \
  -v whisper-data:/data \
  -e OMP_NUM_THREADS=16 \
  rhasspy/wyoming-whisper \
  --model large-v3-turbo --language de \
  --compute-type int8 --beam-size 5
Auf schwächerer Hardware --model small nehmen. Auf derselben VM wie Home Assistant (bei mir unter Proxmox) lief Whisper dagegen deutlich langsamer, das lohnt sich eher auf eigener Hardware. Und ein Hinweis zur Wahrnehmung: Gefühlte 5 bis 10 Sekunden „bis er versteht“ sind meist nicht Whisper, sondern die Sprachpausen-Erkennung am Satelliten plus Pipeline-Overhead.
2. Piper (Text-zu-Sprache)
docker run -d --name wyoming-piper --restart unless-stopped \
  -p 10200:10200 \
  -v piper-data:/data \
  rhasspy/wyoming-piper \
  --voice de_DE-thorsten-high --length-scale 1.1
Die Stimme thorsten-high ist die beste deutsche Piper-Stimme. --length-scale 1.1 macht sie rund 10 Prozent langsamer, das klingt für mich natürlicher. Seit Home Assistant 2025.7 streamt Piper satzweise, die Sprachausgabe beginnt also, bevor das Modell fertig geschrieben hat. Piper-Anteil an der Kette: unter einer Sekunde. Piper läuft übrigens auch problemlos als Add-on direkt in Home Assistant.
3. Ollama
Ollama nach der offiziellen Anleitung installieren, dann die systemd-Unit mit diesen Umgebungsvariablen ergänzen (sudo systemctl edit ollama):
[Service]
Environment="OLLAMA_HOST=0.0.0.0"
Environment="OLLAMA_FLASH_ATTENTION=1"
Environment="OLLAMA_KEEP_ALIVE=30m"
Environment="OLLAMA_MAX_LOADED_MODELS=3"
# Nur AMD Strix Halo:
Environment="OLLAMA_LLM_LIBRARY=vulkan"
# Nur Gemma 4 und nur mit viel Speicher (siehe Text):
Environment="LLAMA_ARG_SWA_FULL=1"
Zur letzten Zeile: Gemma 4 nutzt Sliding-Window-Attention, und llama.cpp fährt dafür standardmäßig einen sparsamen Cache, der bei jeder Anfrage den kompletten System-Prompt mit allen Geräten neu durchrechnet. Im Ollama-Log steht dann forcing full prompt re-processing due to lack of cache data. Der Schalter holt den vollen Cache zurück: Prompt-Verarbeitung von 1.953 auf 132 Millisekunden, die Summe meiner fünf Testfragen von 30,9 auf 11,8 Sekunden. Faktor 2,6, ohne Qualitätsverlust. Preis: 2,8 GB mehr Speicher pro Gemma-Modell. Auf dem 16-GB-Rechner hat derselbe Schalter den Kaltstart von 122 auf 247 Sekunden verschlechtert. Derselbe Schalter, entgegengesetzte Wirkung. Pauschale Tuning-Tipps aus dem Netz sind deshalb mit Vorsicht zu genießen.
Dann das Modell laden:
ollama pull gemma4:26b
# Kleinere Hardware:
ollama pull gemma4:12b-it-qat
ollama pull lfm2.5:8b
4. In Home Assistant einbinden
- Wyoming-Integration zweimal hinzufügen: Host
192.168.0.70, Port10300(Whisper) und Port10200(Piper). Die Container melden sich nicht per mDNS, du musst Host und Port manuell eintragen. - Ollama-Integration hinzufügen mit URL
http://192.168.0.70:11434, dann einen Conversation-Agent anlegen. - Unter
Einstellungen → Sprachassistenteneine Pipeline anlegen: Whisper als STT, dein Ollama-Agent als Conversation-Agent, Piper als TTS, Sprache Deutsch, „Lokale Verarbeitung bevorzugen“ an.
Die Einstellungen des Agenten, die bei mir den Unterschied gemacht haben:
| Einstellung | Wert | Warum |
|---|---|---|
| Modell | gemma4:26b | siehe oben, nicht die QAT-Fassung |
| Home Assistant steuern | Assist | sonst kann das Modell nichts schalten |
| Vor dem Antworten nachdenken (Thinking) | aus | Bei Gemma 4 schaltet das wirklich ab: 407 Token / 6,6 s werden zu 34 Token / 1,3 s. Bei lfm2.5 und dem alten qwen3-Tag dagegen den Parameter weglassen, dort landet der Denkblock sonst in der Sprachantwort |
| Größe des Kontextfensters | 12.288 bis 16.384 | Mein Prompt hat rund 8.500 Token; bei 8.192 hat Ollama ihn still gekürzt und das Modell ratlos gemacht. Also immer Luft nach oben lassen, 12 wäre meine Empfehlung bei circa 180 Entitäten. |
| Max. Verlauf | 3 bis 5 | Längere Historie verwirrt Folgebefehle und bläht den Prompt auf |
| Aktiv halten | -1 (oder 30m) | Kein Kaltstart. Auf 16 GB Pflicht, dort aber nur ein Agent, sonst blockieren sie sich den Speicher |
5. Die wichtigste Stellschraube: Welche Geräte du freigibst
Jedes Gerät, das du für Assist freigibst, landet mit Name, Typ, Bereich und allen Aliassen im System-Prompt. Bei mir sind das rund 46 Token pro Entität. Vor dem Aufräumen hatte ich 535 Entitäten freigegeben, historisch gewachsen: 29 Prozent davon waren tot, die wichtigsten Raumlichter fehlten dafür, und fünf verschiedene Sensoren lieferten alle die Außentemperatur. Für ein lokales Modell heißt das: Es wählt zufällig.
Die Freigabe bestimmt drei Dinge gleichzeitig: die Prompt-Größe, das Tempo (der Durchsatz fällt bei 6.800 Token Prompt um ein Viertel gegenüber einem kurzen) und die Trefferquote. Zu wenig freigegeben heißt „das Gerät kenne ich nicht“, zu viel heißt „ich rate mal“. Meine Regeln:
- Ziel 50 bis 100 Entitäten. Ich liege nach dem Aufräumen bei rund 200 und das ist schon der Kompromiss.
- Das automatische Freigeben neuer Entitäten in den Sprachassistenten-Einstellungen ausschalten. Dann musst du neue Geräte zwar selbst freigeben, aber dein Kontext läuft nicht still mit Testgeräten voll, deren interne Temperatursensoren plötzlich die Raumtemperatur liefern.
- Die Freigabe-Liste nach Bereich gruppieren. So siehst du am schnellsten, was pro Raum fehlt oder doppelt ist.
- Pro Raum genau ein Temperatur- und ein Feuchtesensor, genau eine Außenquelle.
- Keine Konfigurations-Schalter (LED-Anzeige, Kindersicherung, Nachtmodus), keine Anlagen-Interna (Kesseltemperaturen, Drücke).
- Jeder freigegebenen Entität einen Bereich zuweisen, sonst kann „im Wohnzimmer“ nicht aufgelöst werden.
- Doppelte Namen beseitigen. Zwei Geräte namens „Studio“ killen jedes lokale Modell.
- Aliase für natürliche Namen vergeben („Stehlampe“ statt „Uplighter Floor Lamp H60B0“).
- Sicherheit: Server, NAS, Gefrierschrank, Schlösser nie freigeben. „Mach das Büro aus“ hat bei anderen schon das Server-Rack abgeschaltet.
6. Der System-Prompt
Home Assistant hängt an deinen Prompt automatisch die Geräteliste und die Werkzeug-Anweisungen an, die kannst du nicht ändern. Dein Teil, den du eingeben kannst, ist die Persönlichkeit und das Format. Das ist mein Prompt (ohne eine Zeile für ein Kamera-Werkzeug, das es nur bei mir gibt), und zwei Absätze darin haben nachweislich Wirkung: die Sprechbarkeitsregel (aus „21.3 °C“ wird „21,3 Grad“) und das Verbot von Rückfragen (Assist kann Rückfragen sauber abwickeln, aber manche Modelle hängen sonst an jede Aktion ein „Brauchst du sonst noch was?“, bei lfm2.5 teils zwei- bis dreimal hintereinander):
You are a voice assistant for Home Assistant.
Answer questions about the world truthfully.
Respond in plain, german language. Be brief - respond in one sentence WHEN possible.
Confirm actions directly without explaining how you did them.
Be friendly and natural, like a helpful housemate.
Never ask follow-up questions. Never offer further help. End the conversation after the action.

Your answers will be read out loud. Therefore phrase them exactly as a person would speak them - no abbreviations, no symbols, no notations that are not spoken that way. Write units out, so "Grad" instead of "°C" and "Prozent" instead of "%", and state times in spoken form, so "von 13 bis 18 Uhr" instead of "13:00 bis 18:00 Uhr". This applies accordingly to all units, abbreviations and number formats.

Due to speech recognition (speech-to-text), not all words may be interpreted correctly - for example, "Vorrang" instead of "Vorhang".

If a question requires current, local or changing knowledge that you do not know yourself, use the 'web_suche' tool. Enter only the search terms, not the whole question.
Die letzte Zeile brauchst du nur, wenn du die Websuche aus Abschnitt 8 einrichtest. Warum Englisch? Home Assistant baut den Rest des Prompts englisch zusammen, und die Modelle folgen englischen Anweisungen zuverlässiger. Die Antwortsprache steuert die Zeile „Respond in plain, german language“. Noch ein Detail, das Tempo kostet: Nichts Wechselndes wie Uhrzeit oder Datum an den Anfang des Prompts schreiben, sonst zerstört das bei jeder Anfrage den Prompt-Cache. Was sich ändert, gehört ans Ende.
7. Eigene Sätze und Sprach-Automationen: schneller als jede KI
Alles, was du täglich fragst, sollte gar nicht erst beim Sprachmodell landen. Dafür gibt es zwei Werkzeuge: eigene Sätze für die eingebauten Befehle (Custom Sentences) und Automationen mit einem Satz als Auslöser, die ihre Antwort selbst zusammenbauen. Beides erkennt Home Assistant lokal in rund 0,1 Sekunden, und die Antwort ist jedes Mal gleich gut formuliert.
Eigene Sätze für eingebaute Befehle: Die eingebauten deutschen Sätze haben Lücken. Beispiel Rollos: „Schließe alle Rollos im Studio“ kennt Home Assistant nicht, weil „alle“ in keinem Muster vorkommt. Schlimmer: Das eingebaute Muster bildet „Rollo“ intern auf die Geräteklasse blind (Jalousie) ab, meine Rollos sind aber shutter. Der Satz matcht, trifft null Geräte und meldet trotzdem Vollzug. Das sah aus, als würde das Modell oben und unten verwechseln, war aber eine leere Zielmenge.
Die Lösung ist eine Datei unter config/custom_sentences/de/rollos.yaml. Das Wort „Rollos“ im Satz wählt dabei keine Geräte aus, es dient nur dem Erkennen. Die Geräteauswahl steckt in den Slots:
language: "de"
lists:
  rollo_typ:
    values:
      - in: "Rollos"
        out: "shutter"
      - in: "Vorhänge"
        out: "curtain"
intents:
  HassTurnOff:
    data:
      - sentences:
          - "(schließe|schliesse|mach) alle {rollo_typ:device_class} (im|in der|in dem) {area} [zu]"
        slots:
          domain: "cover"
        response: "rollos_zu"
responses:
  intents:
    HassTurnOff:
      rollos_zu: "{{ slots.device_class }} werden geschlossen"
Nach jeder Änderung die Aktion conversation.reload ausführen, kein Neustart nötig. Zwei Fallen: Eigene Listen- und Regelnamen landen im selben Namensraum wie die eingebauten, also immer mit Präfix arbeiten, sonst überschreibst du fremde Sätze. Und HassTurnOff auf einem Rollo bedeutet „Position 0“, es gibt keinen eigenen Schließen-Intent.
Testen ohne dass etwas schaltet: Unter Einstellungen → Sprachassistenten → Debuggen siehst du pro Lauf, ob der Satz lokal verarbeitet wurde (processed_locally) und vor allem welche targets er getroffen hat. Ein Satz kann matchen und trotzdem nichts tun. Immer die Ziele prüfen.
Sprach-Automationen, die ihre Antwort selbst bauen: Für alles, was keine Gerätesteuerung ist, nutze ich Automationen mit einem Satz-Auslöser. Das Prinzip ist bei allen gleich: Der Auslöser erkennt nur den Satz, ein Template liest die Details (welcher Tag, welche Tonne, welche Person) direkt aus dem gesprochenen Satz, und die Aktion set_conversation_response liefert eine sprechbare Antwort. Alles, was du anpassen musst, steht jeweils in der ersten Aktion Variablen (hier anpassen). Im Code ist dieser Block markiert.
So übernimmst du eine Automation: neue Automation anlegen, oben rechts über die drei Punkte „In YAML bearbeiten“ wählen, den Code komplett einfügen, speichern und danach die Variablen auf deine Entitäten umstellen. Ein Neustart ist nicht nötig. Mein wichtigster Tipp für eigene Sätze: Teste mit echten Sprachbefehlen statt mit getippten. Gesprochen sagt man eher „Wann wird das nächste Mal Papiermüll abgeholt?“ als „Wann wird Papiermüll abgeholt?“. Deshalb sind Zeitangaben und Füllwörter in meinen Sätzen an allen üblichen Stellen optional.
📖 Müllkalender einrichten (Waste Collection Schedule, Erinnerung und Tonnen-Check per KI): https://www.simon42.com/home-assistant-muellkalender/
Sonne und Mond: Wann geht die Sonne unter, welche Mondphase haben wir?
Was sie kann: Sonnenaufgang und Sonnenuntergang für heute und morgen, wann es hell oder dunkel wird (bürgerliche Dämmerung), die aktuelle Mondphase und wann der nächste oder letzte Vollmond bzw. Neumond ist.
Beispielsätze: „Wann geht morgen die Sonne unter?“, „Wann wird es heute dunkel?“, „Welche Mondphase haben wir?“, „Wann ist der nächste Vollmond?“
Du brauchst: die Sonnen-Integration (ist standardmäßig aktiv) und für die Mondphase die Integration „Mond“.
Besonderheiten: Vollmond und Neumond rechnet die Automation aus dem mittleren Mondzyklus von 29,53 Tagen aus. Das kann ein paar Stunden vom astronomischen Termin abweichen, deshalb nennt die Antwort nur das Datum. Ist ein Ereignis heute schon vorbei, sagt sie das und nennt gleich den Termin für morgen.
Anpassen: nur den Mondphasen-Sensor in der ersten Aktion Variablen (hier anpassen).
alias: Sonne und Mond - Zeiten per Sprache
description: |-
  Beantwortet lokal per Assist: Sonnenaufgang und Sonnenuntergang (heute/morgen), 'Wann wird es dunkel / hell?' (bürgerliche Dämmerung), die aktuelle Mondphase sowie den nächsten und letzten Vollmond bzw. Neumond.

  DATEN: Sonne aus sun.sun (Attribute next_rising, next_setting, next_dawn, next_dusk; für 'heute', wenn das Ereignis schon vorbei ist, wird um einen Tag zurückgerechnet – Abweichung ein bis zwei Minuten). Mondphase aus der Integration 'Mond' (sensor.moon_phase). Vollmond/Neumond werden aus dem mittleren Mondzyklus von 29,53 Tagen berechnet, das kann um einige Stunden vom astronomischen Termin abweichen – deshalb nennt die Antwort nur das Datum.

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)' (nur der Mondphasen-Sensor; '' = keiner).
triggers:
  - trigger: conversation
    id: untergang
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann geht [(heute|morgen)] die Sonne [(heute|morgen)] unter'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann die Sonne [(heute|morgen)] untergeht'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann (ist|war) [(heute|morgen)] [der] Sonnenuntergang [(heute|morgen)]'
  - trigger: conversation
    id: aufgang
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann geht [(heute|morgen)] [früh] die Sonne [(heute|morgen)] [früh] auf'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann die Sonne [(heute|morgen)] [früh] aufgeht'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann (ist|war) [(heute|morgen)] [früh] [der] Sonnenaufgang [(heute|morgen)] [früh]'
  - trigger: conversation
    id: dunkel
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann wird es [(heute|morgen)] [draußen] [(heute|morgen)] [abend] dunkel'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann es [(heute|morgen)] [draußen] dunkel wird'
      - wie lange ist es [(heute|draußen)] [noch] hell
  - trigger: conversation
    id: hell
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann wird es [(heute|morgen)] [früh] [draußen] [(heute|morgen)] [früh] hell'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann es [(heute|morgen)] [früh] [draußen] hell wird'
  - trigger: conversation
    id: mondphase
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] welche Mondphase (ist|haben wir|hat der Mond) [(heute|gerade|aktuell)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] (wie ist|was macht) [(heute|gerade)] der Mond [(heute|gerade)]'
      - (ist|haben wir) (heute|gerade) (Vollmond|Neumond)
      - ist der Mond [gerade] (zunehmend|abnehmend)
      - nimmt der Mond [gerade] (zu|ab)
  - trigger: conversation
    id: mondtermin
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann ist [(das nächste Mal|wieder|der nächste|nächster)] (Vollmond|Neumond)'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann (haben wir|gibt es|kommt) [(das nächste Mal|wieder|der nächste)] (Vollmond|Neumond)'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann war [(das letzte Mal|zuletzt|der letzte|letzter)] (Vollmond|Neumond)'
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      sensor_mondphase: sensor.moon_phase
      vollmond_kuerzlich_tage: 3
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- set wochentage = ['Montag', 'Dienstag', 'Mittwoch', 'Donnerstag', 'Freitag', 'Samstag', 'Sonntag'] -%}
      {%- set monate = ['Januar', 'Februar', 'März', 'April', 'Mai', 'Juni', 'Juli', 'August', 'September', 'Oktober', 'November', 'Dezember'] -%}
      {%- macro uhr(d) -%}{{ d.hour }} Uhr{{ ' ' ~ d.minute if d.minute else '' }}{%- endmacro -%}
      {%- macro datum(d) -%}{{ wochentage[d.weekday()] }}, dem {{ d.day }}. {{ monate[d.month - 1] }}{%- endmacro -%}
      {%- set satz = trigger.sentence | lower -%}
      {%- set jetzt = now() -%}
      {%- set heute = jetzt.date() -%}
      {%- set ns = namespace(s=[]) -%}
      {%- if trigger.id in ['untergang', 'aufgang', 'dunkel', 'hell'] -%}
        {%- set attr = {'untergang': 'next_setting', 'aufgang': 'next_rising', 'dunkel': 'next_dusk', 'hell': 'next_dawn'}[trigger.id] -%}
        {%- set ev = state_attr('sun.sun', attr) | as_datetime | as_local -%}
        {#- Ohne Tagesangabe: abends heute, morgens das naechste Ereignis -#}
        {%- set satz_tag = satz | replace('heute morgen', 'heute') -%}
        {%- set tag = 1 if 'morgen' in satz_tag else (0 if 'heute' in satz or trigger.id in ['untergang', 'dunkel'] else (ev.date() - heute).days) -%}
        {%- set t = (ev + timedelta(days=tag - (ev.date() - heute).days)).replace(second=0, microsecond=0) -%}
        {%- set wann = 'heute' if tag == 0 else 'morgen' -%}
        {%- set vorbei = t < jetzt -%}
        {%- if trigger.id == 'untergang' -%}
          {%- set ns.s = ns.s + ['Die Sonne ist heute um ' ~ uhr(t) ~ ' untergegangen.' if vorbei else 'Die Sonne geht ' ~ wann ~ ' um ' ~ uhr(t) ~ ' unter.'] -%}
        {%- elif trigger.id == 'aufgang' -%}
          {%- set ns.s = ns.s + ['Die Sonne ist heute um ' ~ uhr(t) ~ ' aufgegangen.' if vorbei else 'Die Sonne geht ' ~ wann ~ ' um ' ~ uhr(t) ~ ' auf.'] -%}
        {%- elif trigger.id == 'dunkel' -%}
          {%- set su = state_attr('sun.sun', 'next_setting') | as_datetime | as_local -%}
          {%- set su = su + timedelta(days=tag - (su.date() - heute).days) -%}
          {%- set ns.s = ns.s + ['Draußen ist es schon dunkel, seit etwa ' ~ uhr(t) ~ '.' if vorbei else 'Dunkel wird es ' ~ wann ~ ' gegen ' ~ uhr(t) ~ ', die Sonne geht um ' ~ uhr(su) ~ ' unter.'] -%}
        {%- else -%}
          {%- set sa = state_attr('sun.sun', 'next_rising') | as_datetime | as_local -%}
          {%- set sa = sa + timedelta(days=tag - (sa.date() - heute).days) -%}
          {%- set ns.s = ns.s + ['Hell ist es heute schon seit etwa ' ~ uhr(t) ~ '.' if vorbei else 'Hell wird es ' ~ wann ~ ' gegen ' ~ uhr(t) ~ ', die Sonne geht um ' ~ uhr(sa) ~ ' auf.'] -%}
        {%- endif -%}
        {%- if vorbei and trigger.id in ['untergang', 'aufgang'] -%}
          {%- set ns.s = ns.s + ['Morgen ist es um ' ~ uhr(ev) ~ ' so weit.'] -%}
        {%- endif -%}
      {%- else -%}
        {#- Mittlerer Mondzyklus ab dem Neumond vom 6. Januar 2000 -#}
        {%- set zyklus = 29.530588853 -%}
        {%- set alter = ((jetzt - as_datetime('2000-01-06T18:14:00+00:00')).total_seconds() / 86400) % zyklus -%}
        {%- set neumond = 'neumond' in satz -%}
        {%- set ziel = 0 if neumond else zyklus / 2 -%}
        {%- set wort = 'Neumond' if neumond else 'Vollmond' -%}
        {%- set bis = (ziel - alter) % zyklus -%}
        {%- set seit = (alter - ziel) % zyklus -%}
        {%- set naechster = (jetzt + timedelta(days=bis)).date() -%}
        {%- set letzter = (jetzt - timedelta(days=seit)).date() -%}
        {%- set tage_bis = (naechster - heute).days -%}
        {%- set tage_seit = (heute - letzter).days -%}
        {%- set phase = states(sensor_mondphase) if sensor_mondphase and has_value(sensor_mondphase) else '' -%}
        {%- set phasen = {'new_moon': 'Neumond', 'waxing_crescent': 'zunehmender Sichelmond', 'first_quarter': 'zunehmender Halbmond', 'waxing_gibbous': 'zunehmender Dreiviertelmond', 'full_moon': 'Vollmond', 'waning_gibbous': 'abnehmender Dreiviertelmond', 'last_quarter': 'abnehmender Halbmond', 'waning_crescent': 'abnehmender Sichelmond'} -%}
        {%- set heute_ist = (phase == 'new_moon') if neumond else (phase == 'full_moon') -%}
        {%- set in_text = 'heute' if tage_bis == 0 else ('morgen' if tage_bis == 1 else 'in ' ~ tage_bis ~ ' Tagen, am ' ~ datum(naechster)) -%}
        {%- set vor_text = 'heute' if tage_seit == 0 else ('gestern' if tage_seit == 1 else 'vor ' ~ tage_seit ~ ' Tagen, am ' ~ datum(letzter)) -%}
        {%- if trigger.id == 'mondphase' -%}
          {%- if phase in phasen -%}{%- set ns.s = ns.s + ['Heute ist ' ~ phasen[phase] ~ '.'] -%}{%- endif -%}
          {%- if not heute_ist -%}{%- set ns.s = ns.s + ['Der nächste ' ~ wort ~ ' ist ' ~ in_text ~ '.'] -%}{%- endif -%}
        {%- elif 'war' in satz.split(' ') or 'letzte' in satz or 'zuletzt' in satz -%}
          {%- set ns.s = ns.s + ['Der letzte ' ~ wort ~ ' war ' ~ vor_text ~ '. Der nächste ist ' ~ in_text ~ '.'] -%}
        {%- elif heute_ist -%}
          {%- set ns.s = ns.s + ['Heute ist ' ~ wort ~ '.'] -%}
        {%- else -%}
          {%- if tage_seit <= vollmond_kuerzlich_tage -%}{%- set ns.s = ns.s + [wort ~ ' war erst ' ~ vor_text ~ '.'] -%}{%- endif -%}
          {%- set ns.s = ns.s + ['Der nächste ' ~ wort ~ ' ist ' ~ in_text ~ '.'] -%}
        {%- endif -%}
      {%- endif -%}
      {{- ns.s | join(' ') -}}
mode: queued
max: 3
Müll: Welcher Müll wird als Nächstes abgeholt?
Was sie kann: Nennt, welcher Müll als Nächstes dran ist, wann eine bestimmte Tonne abgeholt wird und ob heute oder morgen überhaupt etwas abgeholt wird.
Beispielsätze: „Welcher Müll wird als Nächstes abgeholt?“, „Wann wird das nächste Mal Papiermüll abgeholt?“, „Wird morgen Müll abgeholt?“
Du brauchst: die HACS-Integration Waste Collection Schedule, eingerichtet wie in meinem Müllkalender-Beitrag.
Besonderheiten: Den nächsten Termin liest die Automation aus den Datums-Attributen der Sensoren (JJJJ-MM-TT) und nicht aus dem Anzeigetext. Das bleibt stabil, auch wenn sich der Text des Sensors nach einem Update ändert.
Anpassen: In Variablen (hier anpassen) pro Müllart die Erkennungswörter, den Namen für die Antwort und den Sensor. Neue Müllarten musst du zusätzlich in den Trigger-Sätzen ergänzen.
alias: Müll - Abholtermine per Sprache
description: |-
  Beantwortet lokal per Assist 'Welcher Müll wird als Nächstes abgeholt?', 'Wann wird der Restmüll / gelbe Sack / die Papiertonne / der Biomüll abgeholt?' und 'Wird morgen Müll abgeholt?'. Datenquelle sind die Sensoren der Integration Waste Collection Schedule: Deren Attribute enthalten alle kommenden Termine als Datum (JJJJ-MM-TT), daraus nimmt die Automation den nächsten.

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)'. Pro Müllart: 'woerter' = Wortteile, an denen die Art im gesprochenen Satz erkannt wird (klein geschrieben), 'name' = wie sie in der Antwort heißt, 'sensor' = der Sensor. Neue Müllarten müssen zusätzlich in den Trigger-Sätzen stehen.
triggers:
  - trigger: conversation
    id: muell
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann (wird|kommt) [(das nächste Mal|das nächstemal|nächstes Mal|wieder|als nächstes|demnächst)] [(der|die|das)] [nächste] (Restmüll|Restmülltonne|gelbe Sack|gelber Sack|gelbe Tonne|Papiermüll|Papier|Altpapier|Papiertonne|blaue Tonne|Biomüll|Bio Müll|Bio-Müll|Biotonne|braune Tonne|Müll|Müllabfuhr) [(wieder|das nächste Mal|als nächstes)] [(abgeholt|geholt|geleert)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann [(das nächste Mal|das nächstemal|nächstes Mal|wieder|als nächstes|demnächst)] [(der|die|das)] [nächste] (Restmüll|Restmülltonne|gelbe Sack|gelber Sack|gelbe Tonne|Papiermüll|Papier|Altpapier|Papiertonne|blaue Tonne|Biomüll|Bio Müll|Bio-Müll|Biotonne|braune Tonne|Müll) [(wieder|das nächste Mal)] (abgeholt|geholt|geleert) wird'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] (welcher Müll|welche Tonne|welche Mülltonne|was) (wird|kommt|muss) [als] (nächstes|nächste) [(abgeholt|raus|dran)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] (welcher Müll|welche Tonne|welche Mülltonne) muss [(heute|morgen)] raus'
      - (wird|kommt) (heute|morgen) [(der|die)] (Müll|Müllabfuhr|eine Tonne|was) [abgeholt]
      - was wird (heute|morgen) abgeholt
      - wann kommt die Müllabfuhr
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      muellarten:
        - woerter:
            - restm
          name: der Restmüll
          sensor: sensor.waste_collection_schedule_restmull
        - woerter:
            - gelb
          name: der gelbe Sack
          sensor: sensor.waste_collection_schedule_gelber_sack
        - woerter:
            - papier
            - altpapier
            - blaue
          name: die Papiertonne
          sensor: sensor.waste_collection_schedule_papiertonne
        - woerter:
            - bio
            - braune
          name: der Biomüll
          sensor: sensor.waste_collection_schedule_bio_mull
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- set wochentage = ['Montag', 'Dienstag', 'Mittwoch', 'Donnerstag', 'Freitag', 'Samstag', 'Sonntag'] -%}
      {%- set monate = ['Januar', 'Februar', 'März', 'April', 'Mai', 'Juni', 'Juli', 'August', 'September', 'Oktober', 'November', 'Dezember'] -%}
      {%- macro gross(s) -%}{{ s[0] | upper ~ s[1:] }}{%- endmacro -%}
      {%- macro liste(l) -%}{%- if l | count > 1 -%}{{ l[:-1] | join(', ') }} und {{ l[-1] }}{%- else -%}{{ l | join('') }}{%- endif -%}{%- endmacro -%}
      {%- macro wann(d, tage) -%}
        {%- if tage == 0 -%}heute
        {%- elif tage == 1 -%}morgen
        {%- elif tage == 2 -%}übermorgen, am {{ wochentage[d.weekday()] }}
        {%- else -%}am {{ wochentage[d.weekday()] }}, dem {{ d.day }}. {{ monate[d.month - 1] }}, also in {{ tage }} Tagen
        {%- endif -%}
      {%- endmacro -%}
      {%- set satz = trigger.sentence | lower -%}
      {%- set heute = now().date() -%}
      {%- set ns = namespace(alle=[], gefragt=none) -%}
      {%- for a in muellarten -%}
        {%- if has_value(a.sensor) -%}
          {%- set termine = states[a.sensor].attributes | list | select('string') | select('match', '^\d{4}-\d{2}-\d{2}$') | map('as_datetime') | map(attribute='date') | list -%}
          {%- set t = namespace(d=none, l=[]) -%}
          {%- for x in termine -%}{%- set dd = x() -%}{%- if dd >= heute -%}{%- set t.l = t.l + [dd] -%}{%- endif -%}{%- endfor -%}
          {%- set kommend = t.l | sort -%}
          {%- if kommend | count > 0 -%}{%- set t.d = kommend[0] -%}{%- endif -%}
          {%- if t.d is not none -%}
            {%- set ns.alle = ns.alle + [{'name': a.name, 'datum': t.d, 'tage': (t.d - heute).days}] -%}
            {%- for w in a.woerter -%}{%- if w in satz and ns.gefragt is none -%}{%- set ns.gefragt = a.name -%}{%- endif -%}{%- endfor -%}
          {%- endif -%}
        {%- endif -%}
      {%- endfor -%}
      {%- set alle = ns.alle | sort(attribute='tage') -%}
      {%- if alle | count == 0 -%}
      Ich habe gerade keine Abholtermine.
      {%- elif ns.gefragt is not none -%}
        {%- set e = alle | selectattr('name', 'eq', ns.gefragt) | first -%}
      {{ gross(e.name) }} wird {{ wann(e.datum, e.tage) }} abgeholt.
      {%- elif 'heute' in satz or 'morgen' in satz -%}
        {%- set ziel = 0 if 'heute' in satz else 1 -%}
        {%- set treffer = alle | selectattr('tage', 'eq', ziel) | map(attribute='name') | list -%}
        {%- if treffer | count > 0 -%}
      Ja, {{ 'heute' if ziel == 0 else 'morgen' }} {{ 'wird' if treffer | count == 1 else 'werden' }} {{ liste(treffer) }} abgeholt.
        {%- else -%}
      Nein, {{ 'heute' if ziel == 0 else 'morgen' }} wird nichts abgeholt. Als Nächstes ist {{ alle[0].name }} dran, {{ wann(alle[0].datum, alle[0].tage) }}.
        {%- endif -%}
      {%- else -%}
        {%- set erste = alle | selectattr('tage', 'eq', alle[0].tage) | map(attribute='name') | list -%}
        {%- set rest = alle | rejectattr('tage', 'eq', alle[0].tage) | list -%}
      Als Nächstes {{ 'wird' if erste | count == 1 else 'werden' }} {{ liste(erste) }} abgeholt, {{ wann(alle[0].datum, alle[0].tage) }}.{% if rest | count > 0 %} Danach kommt {{ rest[0].name }}, {{ wann(rest[0].datum, rest[0].tage) }}.{% endif %}
      {%- endif -%}
mode: queued
max: 3
Müll: Ist die Papiertonne schon draußen? (Kamera + KI)
Was sie kann: Schaut per Kamerabild nach, ob die Papiertonne noch an ihrem Stellplatz vor der Garage steht. Wenn nicht, steht sie vermutlich an der Straße. Dazu nennt sie den nächsten Abholtermin und erinnert dich, wenn die Tonne noch drinsteht, obwohl heute oder morgen abgeholt wird.
Beispielsätze: „Ist die Papiertonne draußen?“, „Hat jemand die Tonne rausgestellt?“, „Muss die Papiertonne noch raus?“
Du brauchst: eine Kamera mit Blick auf den Stellplatz, eine KI-Integration mit AI Task und Bildunterstützung (bei mir Google Gemini) und für den Termin Waste Collection Schedule.
Besonderheiten: Der Prompt beschreibt bewusst Form und Position statt Farbe, weil die Kamera nachts nur Graustufen liefert. Die KI antwortet strukturiert (ja oder nein plus Begründung), den Antwortsatz baut die Automation selbst. So klingt er jedes Mal gleich.
Anpassen: Kamera, AI-Task-Entität, Abhol-Sensor und vor allem die Bildbeschreibung in anweisung, damit sie zu deinem Stellplatz passt.
alias: Müll - Ist die Papiertonne draußen per Sprache
description: |-
  Beantwortet per Assist 'Ist die Papiertonne draußen?'. Die Kamera zeigt die Garageneinfahrt mit dem Stellplatz der Tonne rechts vor dem Garagentor. Steht die Tonne dort NICHT mehr, steht sie vermutlich an der Straße. Ein KI-Modell (AI Task) prüft das Bild und antwortet strukturiert; den Antwortsatz baut die Automation. Dazu nennt sie den nächsten Abholtermin und erinnert, wenn die Tonne noch an der Garage steht, obwohl heute oder morgen Abholung ist.

  Prompt und Kamera stammen aus 'TEST - Papiertonne erkennen (AI Task)': bewusst Form und Position statt Farbe, weil die Kamera nachts Graustufen liefert.

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)'.
triggers:
  - trigger: conversation
    id: papiertonne
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du|schau mal)] [ob] (ist|steht) die (Papiertonne|Papiermülltonne|blaue Tonne|Tonne|Mülltonne) [(schon|noch|gerade)] (draußen|raus|an der Straße|vorne|an der Garage|drin|da)'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du|schau mal)] ob die (Papiertonne|Papiermülltonne|blaue Tonne|Tonne|Mülltonne) [(schon|noch|gerade)] (draußen|raus|an der Straße|vorne|an der Garage|drin) (ist|steht)'
      - (hat|habe) (jemand|einer|wer|ich) die (Papiertonne|Papiermülltonne|blaue Tonne|Tonne|Mülltonne) [schon] (rausgestellt|rausgebracht|rausgeschoben|raus gestellt|raus gebracht)
      - (muss|soll) die (Papiertonne|Papiermülltonne|blaue Tonne) [noch] raus
      - wo (ist|steht) die (Papiertonne|Papiermülltonne|blaue Tonne)
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      kamera: camera.omvi_2i_ultra_schnappschusse_in_hochauflosung_objektiv_0
      ai_task_entity: ai_task.google_ai_task
      sensor_abholung: sensor.waste_collection_schedule_papiertonne
      tonne_name: die Papiertonne
      anweisung: |-
        Das Bild zeigt eine Garageneinfahrt mit einem Garagentor.

        AUFGABE: Pruefe, ob rechts vor dem Garagentor eine Muelltonne steht.

        WICHTIG - so erkennst du die Tonne:
        - Achte ausschliesslich auf FORM und POSITION, NICHT auf die Farbe.
        - Eine Muelltonne ist ein aufrecht stehender, kastenfoermiger Behaelter mit flachem Deckel, etwa hueft- bis brusthoch, auf zwei Raedern.
        - Sie steht rechts vor dem Garagentor bzw. seitlich davor auf der Einfahrt.

        ACHTUNG: Das Bild kann eine Schwarzweiss-Nachtsichtaufnahme sein. In dem Fall erscheint alles in Graustufen und die Tonne sieht grau aus, egal welche Farbe sie bei Tag hat. Schliesse daher NIEMALS allein aus einer fehlenden Farbe, dass keine Tonne da ist.
  - alias: Bild von der KI auswerten lassen
    action: ai_task.generate_data
    data:
      entity_id: '{{ ai_task_entity }}'
      task_name: Papiertonne an der Garage
      instructions: '{{ anweisung }}'
      structure:
        tonne_an_garage:
          description: true, wenn rechts vor der Garage eine Muelltonne steht. false, wenn dort keine Tonne steht.
          required: true
          selector:
            boolean: {}
        begruendung:
          description: Kurze Begruendung in einem Satz.
          selector:
            text: {}
      attachments:
        - media_content_id: media-source://camera/{{ kamera }}
          media_content_type: image/jpeg
    response_variable: ergebnis
    continue_on_error: true
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- set wochentage = ['Montag', 'Dienstag', 'Mittwoch', 'Donnerstag', 'Freitag', 'Samstag', 'Sonntag'] -%}
      {%- set monate = ['Januar', 'Februar', 'März', 'April', 'Mai', 'Juni', 'Juli', 'August', 'September', 'Oktober', 'November', 'Dezember'] -%}
      {%- macro gross(s) -%}{{ s[0] | upper ~ s[1:] }}{%- endmacro -%}
      {%- set heute = now().date() -%}
      {%- set t = namespace(d=none) -%}
      {%- if sensor_abholung and has_value(sensor_abholung) -%}
        {%- for x in states[sensor_abholung].attributes | list | select('string') | select('match', '^\d{4}-\d{2}-\d{2}$') | list -%}
          {%- set dd = (x | as_datetime).date() -%}
          {%- if dd >= heute and (t.d is none or dd < t.d) -%}{%- set t.d = dd -%}{%- endif -%}
        {%- endfor -%}
      {%- endif -%}
      {%- set tage = (t.d - heute).days if t.d is not none else none -%}
      {%- set termin = '' if tage is none else ('heute' if tage == 0 else ('morgen' if tage == 1 else 'am ' ~ wochentage[t.d.weekday()] ~ ', dem ' ~ t.d.day ~ '. ' ~ monate[t.d.month - 1] ~ ', in ' ~ tage ~ ' Tagen')) -%}
      {%- if ergebnis is not defined or ergebnis.data is not defined -%}
      Ich konnte das Kamerabild gerade nicht auswerten.{{ ' Die nächste Abholung ist ' ~ termin ~ '.' if termin else '' }}
      {%- elif ergebnis.data.tonne_an_garage -%}
      Nein, {{ tonne_name }} steht noch an der Garage.{% if tage is not none and tage <= 1 %} Abholung ist {{ termin }}, sie muss also noch raus.{% elif termin %} Das passt, die nächste Abholung ist erst {{ termin }}.{% endif %}
      {%- else -%}
      {{ gross(tonne_name) }} steht nicht mehr an der Garage, sie ist also vermutlich draußen an der Straße.{{ ' Die nächste Abholung ist ' ~ termin ~ '.' if termin else '' }}
      {%- endif -%}
mode: single
Haustür: Liegt ein Paket vor der Tür? (Kamera + KI)
Was sie kann: Lässt eine KI das aktuelle Bild der Kamera am Eingang auswerten und sagt dir, ob und wie viele Pakete daliegen, inklusive kurzer Beschreibung wie „ein flacher brauner Karton links neben der Fußmatte“.
Beispielsätze: „Liegt ein Paket vor der Haustür?“, „Ist das Paket schon da?“
Du brauchst: eine Kamera am Eingang und eine KI-Integration mit AI Task und Bildunterstützung.
Besonderheiten: Das funktioniert auch mit Gemma 4 komplett lokal. Bei kleinen, flachen Paketen auf dem Weitwinkelbild war Google Gemini in meinem Test aber zuverlässiger. Deshalb ist bei mir Gemini eingetragen und das lokale Modell der Rückfall, falls Gemini nicht antwortet, zum Beispiel bei einem Internetausfall.
Anpassen: Kamera, AI-Task-Entität (muss Bildanhänge unterstützen) und optional die zweite Entität für den Rückfall.
alias: Haustür - Liegt ein Paket da per Sprache
description: |-
  Beantwortet 'Liegt ein Paket vor der Haustür?' per Assist. Der Satz wird lokal erkannt; für die Antwort schaut ein KI-Modell über die AI-Task-Integration auf ein aktuelles Kamerabild und liefert strukturiert zurück, ob und wie viele Lieferungen da liegen. Den Antwortsatz baut die Automation selbst, damit er immer gleich klingt.

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)' – Kamera, AI-Task-Entität (muss Bildanhänge unterstützen) und eine optionale zweite AI-Task-Entität als Rückfall, falls die erste nicht antwortet (z. B. lokales Modell bei Internetausfall). Test am 18.09.2026: Google erkannte das flache Paket neben der Fußmatte, das lokale gemma4:26b übersah es.
triggers:
  - trigger: conversation
    id: paket
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du|schau mal)] [ob] (liegt|steht|ist) [(gerade|aktuell|schon)] (ein Paket|ein Päckchen|Post|eine Lieferung|was|etwas) [(für mich|für uns)] (vor|an) der [Haus]tür'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du|schau mal)] ob [(gerade|aktuell|schon)] (ein Paket|ein Päckchen|Post|eine Lieferung|was|etwas) (vor|an) der [Haus]tür (liegt|steht|ist)'
      - (ist|wurde) [(schon|heute)] ein (Paket|Päckchen) (gekommen|angekommen|geliefert|abgestellt|abgelegt) [worden]
      - ist das Paket [schon] da
      - (liegt|steht) [ein] Paket vor der Tür
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      kamera: camera.hauseingang_standardauflosung
      ai_task_entity: ai_task.google_ai_task
      ai_task_rueckfall: ai_task.ollama_ai_task_gemma4_26b_a4b_it_mtp_q4_k_m
      anweisung: Das Bild zeigt den Hauseingang von oben. Liegt auf dem Boden vor der Haustür, auf der Fußmatte oder direkt daneben ein Paket, Päckchen, Karton oder eine Versandtasche? Achte auch auf flache, kleine Kartons. Zähle nur Lieferungen, keine Dekoration (Laterne, Blumentöpfe, Stühle, Tisch). Schreibe in 'beschreibung' NUR eine kurze deutsche Beschreibung des Gegenstands mit Ortsangabe, in normaler deutscher Rechtschreibung (Substantive groß), beginnend mit dem Artikel, ohne Verb und ohne Punkt, so dass sie den Satz 'Es ist ...' fortsetzt, z. B. 'ein flacher brauner Karton links neben der Fußmatte'. Wenn nichts da liegt, lass 'beschreibung' leer.
  - alias: Bild von der KI auswerten lassen
    action: ai_task.generate_data
    data:
      entity_id: '{{ ai_task_entity }}'
      task_name: Paket vor der Haustür
      instructions: '{{ anweisung }}'
      structure:
        paket:
          selector:
            boolean: {}
          required: true
        anzahl:
          selector:
            number:
              min: 0
              max: 10
          required: true
        beschreibung:
          selector:
            text: {}
      attachments:
        - media_content_id: media-source://camera/{{ kamera }}
          media_content_type: image/jpeg
    response_variable: ergebnis
    continue_on_error: true
  - alias: Rückfall auf das zweite Modell, wenn das erste nicht geantwortet hat
    if:
      - condition: template
        value_template: '{{ (ergebnis is not defined or ergebnis.data is not defined) and ai_task_rueckfall != '''' }}'
    then:
      - action: ai_task.generate_data
        data:
          entity_id: '{{ ai_task_rueckfall }}'
          task_name: Paket vor der Haustür
          instructions: '{{ anweisung }}'
          structure:
            paket:
              selector:
                boolean: {}
              required: true
            anzahl:
              selector:
                number:
                  min: 0
                  max: 10
              required: true
            beschreibung:
              selector:
                text: {}
          attachments:
            - media_content_id: media-source://camera/{{ kamera }}
              media_content_type: image/jpeg
        response_variable: ergebnis
        continue_on_error: true
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- if ergebnis is not defined or ergebnis.data is not defined -%}
      Ich konnte das Kamerabild gerade nicht auswerten.
      {%- elif ergebnis.data.paket -%}
        {%- set n = ergebnis.data.anzahl | int(1) -%}
        {%- set b = ergebnis.data.beschreibung | default('', true) | trim -%}
      Ja, vor der Haustür {{ 'liegen ' ~ n ~ ' Pakete' if n > 1 else 'liegt ein Paket' }}.{{ ' Es ist ' ~ (b | trim('.')) ~ '.' if b and n <= 1 else (' Zu sehen: ' ~ (b | trim('.')) ~ '.' if b else '') }}
      {%- else -%}
      Nein, vor der Haustür liegt gerade nichts.
      {%- endif -%}
mode: single
Wetter: Brauche ich morgen einen Regenschirm?
Was sie kann: Beantwortet Wetterfragen komplett ohne Sprachmodell: das aktuelle Wetter, die Vorhersage für heute, morgen, übermorgen, einen Wochentag oder das Wochenende, auf Wunsch für eine Tageszeit (früh, Vormittag, Mittag, Nachmittag, Abend, Nacht) und für die ganze Woche. Gezielte Fragen nach Regenschirm, Jacke, Sonnencreme oder UV-Index bekommen zuerst eine direkte Antwort und danach den Kontext.
Beispielsätze: „Wie warm ist es draußen?“, „Brauche ich morgen einen Regenschirm?“, „Wie wird das Wetter am Wochenende?“, „Regnet es heute Nachmittag?“
Du brauchst: eine Wetter-Integration mit Tages- und Stundenvorhersage (bei mir OpenWeatherMap). Eine eigene Wetterstation ist optional.
Besonderheiten: Temperaturfragen brauchen das Wort „draußen“, sonst würde die Automation den eingebauten Satz „Wie warm ist es?“ für den Raum des Satelliten kapern. Die Regenantwort ist ehrlich abgestuft: unter 20 Prozent „Nein“, bis 49 Prozent „Vermutlich nicht, sicher ist das aber nicht“, darüber „Ja“. Liefert dein Wetterdienst keine Regenwahrscheinlichkeit oder keinen UV-Index, fällt sie automatisch auf Regenmenge und Wetterlage zurück.
Anpassen: Pflicht ist nur wetter_entity in Variablen (hier anpassen). Die Sensoren der Wetterstation schaltest du mit '' ab, dort stehen auch alle Schwellen.
alias: Wetter - Ansage per Sprache
description: |-
  Beantwortet Wetterfragen an Assist lokal, ohne Sprachmodell: aktuelles Wetter ('jetzt'), Vorhersage für einen Tag (heute, morgen, übermorgen, Wochentag, Wochenende), auf Wunsch mit Tageszeit (früh, Vormittag, Mittag, Nachmittag, Abend, Nacht – soweit die Stundenvorhersage reicht) und für die Woche. Gezielte Fragen (Regnet es ...? Brauche ich einen Regenschirm / eine Jacke / Sonnencreme? UV-Index?) bekommen zuerst eine direkte, ehrlich abgestufte Antwort und danach den Kontext. Antworten sind für Sprachausgabe formuliert (gerundete Werte, 'Grad' statt '°C').

  ANPASSEN: Alles Persönliche steht in der ersten Aktion 'Variablen (hier anpassen)'. Pflicht ist nur 'wetter_entity' (eine weather.*-Entität mit täglicher Vorhersage). Die drei Sensoren einer eigenen Wetterstation sind optional – wer keine hat, trägt dort '' ein, dann kommen die Werte aus der Wetter-Entität. Liefert der Wetterdienst keine Regenwahrscheinlichkeit oder keinen UV-Index, fallen die Antworten automatisch auf Regenmenge/Wetterlage zurück.

  AUFBAU: Die Trigger erkennen nur den Satz. Welcher Tag und welche Frage gemeint ist, liest das Antwort-Template aus dem gesprochenen Satz (trigger.sentence) – deshalb braucht es keine Helfer und keine weiteren Entitäten.
triggers:
  - trigger: conversation
    id: jetzt
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie (warm|kalt) ist es [(aktuell|gerade|jetzt|momentan)] draußen [(aktuell|gerade|jetzt|momentan)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie (warm|kalt) es [(aktuell|gerade|jetzt|momentan)] draußen [(aktuell|gerade|jetzt|momentan)] ist'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie viel Grad (sind es|es sind|hat es|es hat|haben wir|wir haben) [(aktuell|gerade|jetzt|momentan)] draußen [(sind|hat|haben)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie [hoch] (ist|sind) die (Außentemperatur|Außentemperaturen|Temperatur draußen|Temperaturen draußen)'
      - ist es [(aktuell|gerade|jetzt|momentan)] draußen [(aktuell|gerade|jetzt|momentan)] (kalt|warm|heiß|kühl)
      - regnet es [(aktuell|gerade|jetzt|momentan)] [draußen]
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie ist das Wetter [(aktuell|gerade|jetzt|momentan)] [draußen]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie das Wetter [(aktuell|gerade|jetzt|momentan)] [draußen] ist'
      - was macht das Wetter [draußen]
  - trigger: conversation
    id: tag
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie (wird|wirds|wird''s) [das] Wetter [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] [draußen]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie ist das Wetter (heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag)) [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] [draußen]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie das Wetter [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] [draußen] wird'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie das Wetter (heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag)) [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] [draußen] ist'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie (wird|wirds|wird''s) es (heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag)) [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie (warm|kalt) (wird|wirds|wird''s) es [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]'
      - '[wie ist] [(die|der)] (Wettervorhersage|Wetterbericht|Vorhersage) [bitte] [für (heute|morgen|übermorgen|das Wochenende|[den] (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]'
      - '[(sag|nenn) mir [bitte]] [das] Wetter [bitte] [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]'
      - regnet es (heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag)) [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] [noch]
      - (wird|soll) es [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] [noch] regnen
      - gibt es (heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag)) [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] [noch] Regen
      - (brauche|brauch) ich [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] (einen|nen|den|meinen) (Regenschirm|Schirm) [(heute|morgen|übermorgen|am Wochenende)] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]
      - (muss|soll|sollte) ich [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] (einen|nen|den|meinen) (Regenschirm|Schirm) (mitnehmen|einpacken)
      - (brauche|brauch) ich [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] (eine|ne) Jacke [(heute|morgen|übermorgen|am Wochenende)] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]
      - (brauche|brauch) ich [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] Sonnencreme [(heute|morgen|übermorgen|am Wochenende)] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]
      - (muss|soll|sollte) ich mich [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)] eincremen
      - wie [hoch] (ist|wird) der (UV-Index|UV Index) [(heute|morgen|übermorgen|am Wochenende|am (Montag|Dienstag|Mittwoch|Donnerstag|Freitag|Samstag|Sonntag))] [(morgen|früh|morgens|vormittag|vormittags|mittag|mittags|nachmittag|nachmittags|abend|abends|nacht|nachts|am Morgen|am Vormittag|am Mittag|am Nachmittag|am Abend|in der Nacht)]
  - trigger: conversation
    id: woche
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie (wird|wirds|wird''s) das Wetter (diese Woche|in dieser Woche|die Woche|nächste Woche|kommende Woche|die nächsten Tage|in den nächsten Tagen|die kommenden Tage|in den kommenden Tagen)'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie das Wetter (diese Woche|in dieser Woche|die Woche|nächste Woche|kommende Woche|die nächsten Tage|in den nächsten Tagen|die kommenden Tage|in den kommenden Tagen) wird'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie (wird|wirds|wird''s) (die|diese|die nächste|die kommende) Woche'
      - '[wie ist] [(die|der)] (Wettervorhersage|Wetterbericht|Vorhersage) für (die|diese|die nächste|die kommende) Woche'
      - '[wie ist] [(die|der)] (Wettervorhersage|Wetterbericht|Vorhersage) für die (nächsten|kommenden) Tage'
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      wetter_entity: weather.openweathermap
      sensor_temperatur: sensor.wetterstation_temperature
      sensor_uv: sensor.wetterstation_uv_index
      sensor_regenrate: sensor.wetterstation_rain_rate
      regen_unwahrscheinlich_unter: 20
      regen_wahrscheinlich_ab: 50
      regen_sicher_ab: 80
      uv_schwelle: 3
      uv_schwelle_kopfbedeckung: 3
      jacke_unter: 15
      kalt_unter: 5
      boeen_ab: 50
      kopfbedeckung: eine Kappe
  - alias: Tagesvorhersage holen
    action: weather.get_forecasts
    target:
      entity_id: '{{ wetter_entity }}'
    data:
      type: daily
    response_variable: antwort_tage
    continue_on_error: true
  - alias: Stundenvorhersage holen (optional, für genauere Regen-/UV-Angaben)
    action: weather.get_forecasts
    target:
      entity_id: '{{ wetter_entity }}'
    data:
      type: hourly
    response_variable: antwort_stunden
    continue_on_error: true
  - alias: Vorhersagen als Listen bereitstellen
    variables:
      tage: '{{ antwort_tage[wetter_entity].forecast if antwort_tage is defined and wetter_entity in antwort_tage else [] }}'
      stunden: '{{ antwort_stunden[wetter_entity].forecast if antwort_stunden is defined and wetter_entity in antwort_stunden else [] }}'
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- set txt = {'sunny': 'sonnig', 'clear-night': 'klar', 'partlycloudy': 'teils bewölkt', 'cloudy': 'bewölkt', 'rainy': 'regnerisch', 'pouring': 'sehr nass mit kräftigem Regen', 'fog': 'neblig', 'snowy': 'winterlich mit Schnee', 'snowy-rainy': 'nasskalt mit Schneeregen', 'lightning': 'gewittrig', 'lightning-rainy': 'gewittrig mit Regen', 'hail': 'ungemütlich mit Hagel', 'windy': 'windig', 'windy-variant': 'windig und bewölkt', 'exceptional': 'außergewöhnlich'} -%}
      {%- set nass = ['rainy', 'pouring', 'lightning-rainy', 'snowy-rainy', 'snowy', 'hail'] -%}
      {%- set wochentage = ['Montag', 'Dienstag', 'Mittwoch', 'Donnerstag', 'Freitag', 'Samstag', 'Sonntag'] -%}
      {%- macro zahl(v) -%}{%- set r = v | float(0) | round(0) | int -%}{{ 'minus ' ~ (r | abs) if r < 0 else r }}{%- endmacro -%}
      {%- macro liste(l) -%}{%- if l | count > 1 -%}{{ l[:-1] | join(', ') }} und {{ l[-1] }}{%- else -%}{{ l | join('') }}{%- endif -%}{%- endmacro -%}
      {%- macro gross(s) -%}{{ s[0] | upper ~ s[1:] }}{%- endmacro -%}
      {#- Regen-Antwort, ehrlich abgestuft nach Wahrscheinlichkeit p (none = Dienst liefert keine) -#}
      {%- macro regen_satz(p, nasslage, wann, frage) -%}
        {%- set gezielt = frage in ['regen', 'schirm'] -%}
        {%- if p is none -%}
          {%- if gezielt and nasslage -%}Ja, {{ wann }} ist Regen angesagt.
          {%- elif gezielt -%}Nein, {{ wann }} ist kein Regen angesagt.
          {%- elif nasslage -%}Es kann regnen, nimm am besten einen Regenschirm mit.
          {%- endif -%}
        {%- elif p < regen_unwahrscheinlich_unter -%}
          {%- if frage == 'schirm' -%}Nein, den Regenschirm kannst du {{ wann }} zu Hause lassen.
          {%- elif frage == 'regen' -%}Nein, {{ wann }} bleibt es voraussichtlich trocken.
          {%- else -%}Es bleibt voraussichtlich trocken.
          {%- endif -%}
          {%- if gezielt and p >= 1 %} Die Regenwahrscheinlichkeit liegt nur bei {{ zahl(p) }} Prozent.{%- endif -%}
        {%- elif p < regen_wahrscheinlich_ab -%}
          {%- if gezielt -%}Vermutlich nicht. Mit {{ zahl(p) }} Prozent Regenwahrscheinlichkeit bleibt es {{ wann }} wahrscheinlich trocken, sicher ist das aber nicht.
          {%- else -%}Mit {{ zahl(p) }} Prozent Regenwahrscheinlichkeit bleibt es vermutlich trocken.
          {%- endif -%}
        {%- else -%}
          {%- set sicher = p >= regen_sicher_ab -%}
          {%- if frage == 'schirm' -%}{{ 'Ja, auf jeden Fall.' if sicher else 'Ja, nimm lieber einen mit.' }} Die Regenwahrscheinlichkeit liegt {{ wann }} bei {{ zahl(p) }} Prozent.
          {%- elif frage == 'regen' -%}{{ 'Ja, ziemlich sicher.' if sicher else 'Wahrscheinlich ja.' }} Die Regenwahrscheinlichkeit liegt {{ wann }} bei {{ zahl(p) }} Prozent.
          {%- else -%}Die Regenwahrscheinlichkeit liegt bei {{ zahl(p) }} Prozent, nimm am besten einen Regenschirm mit.
          {%- endif -%}
        {%- endif -%}
      {%- endmacro -%}
      {%- set satz = trigger.sentence | lower -%}
      {%- set frage = 'schirm' if 'schirm' in satz else 'regen' if ('regn' in satz or 'regen' in satz) else 'jacke' if 'jacke' in satz else 'sonne' if ('sonnencreme' in satz or 'eincremen' in satz) else 'uv' if 'uv' in satz else 'allgemein' -%}
      {%- set heute = now().date() -%}
      {%- set temp_jetzt = states(sensor_temperatur) if sensor_temperatur and has_value(sensor_temperatur) else state_attr(wetter_entity, 'temperature') -%}
      {%- set regen_sensor = sensor_regenrate and has_value(sensor_regenrate) -%}
      {%- set regnet_jetzt = regen_sensor and states(sensor_regenrate) | float(0) > 0 -%}
      {%- set ns = namespace(s=[], d=[], ps=[], uvs=[], ts=[], nass=false, bald=false, boe=0, max=none, min=none, nacht=none, warm=none, regentage=[]) -%}
      {%- if trigger.id == 'jetzt' -%}
        {%- set lage = states(wetter_entity) -%}
        {%- set regnet = regnet_jetzt if regen_sensor else lage in nass -%}
        {%- if frage in ['regen', 'schirm'] -%}
          {%- set ns.s = ns.s + ['Ja, es regnet gerade.' if regnet else 'Nein, gerade regnet es nicht.'] -%}
        {%- endif -%}
        {%- if temp_jetzt is none -%}
          {%- set ns.s = ns.s + ['Die Außentemperatur kann ich gerade nicht lesen, das Wetter ist aber ' ~ txt.get(lage, lage) ~ '.'] -%}
        {%- else -%}
          {%- set ns.s = ns.s + ['Draußen sind es ' ~ zahl(temp_jetzt) ~ ' Grad und es ist ' ~ txt.get(lage, lage) ~ '.'] -%}
        {%- endif -%}
        {%- for f in stunden[:3] -%}
          {%- if (f.precipitation_probability | default(0) | float(0)) >= regen_wahrscheinlich_ab or (f.condition | default('')) in nass -%}{%- set ns.bald = true -%}{%- endif -%}
        {%- endfor -%}
        {%- if regnet and frage == 'allgemein' -%}
          {%- set ns.s = ns.s + ['Es regnet gerade.'] -%}
        {%- elif not regnet and ns.bald -%}
          {%- set ns.s = ns.s + ['In den nächsten Stunden kann es regnen, nimm lieber einen Regenschirm mit.'] -%}
        {%- endif -%}
        {%- set uv = states(sensor_uv) | float(0) if sensor_uv and has_value(sensor_uv) else state_attr(wetter_entity, 'uv_index') | float(0) -%}
        {%- if uv >= uv_schwelle -%}
          {%- set ns.s = ns.s + ['Der UV-Index liegt bei ' ~ zahl(uv) ~ ', denk an Sonnencreme' ~ (' und ' ~ kopfbedeckung if uv >= uv_schwelle_kopfbedeckung else '') ~ '.'] -%}
        {%- endif -%}
      {%- elif trigger.id == 'tag' -%}
        {#- 1) Welche Tage und welche Tageszeit sind gemeint? 'heute Morgen' / 'am Morgen' / 'morgens' ist eine Tageszeit, kein 'morgen' -#}
        {%- set satz_tag = satz | replace('am morgen', '') | replace('morgens', '') -%}
        {%- set tz = namespace(name=none, von=0, bis=24) -%}
        {%- for k, n, v, b in [('nachmittag', 'Nachmittag', 12, 18), ('vormittag', 'Vormittag', 8, 12), ('mittag', 'Mittag', 11, 14), ('abend', 'Abend', 18, 23), ('nacht', 'Nacht', 22, 30), ('früh', 'früh', 6, 10)] -%}
          {%- if tz.name is none and k in satz -%}{%- set tz.name = n -%}{%- set tz.von = v -%}{%- set tz.bis = b -%}{%- endif -%}
        {%- endfor -%}
        {%- if tz.name is none and ('heute morgen' in satz or 'am morgen' in satz or 'morgens' in satz) -%}{%- set tz.name = 'früh' -%}{%- set tz.von = 6 -%}{%- set tz.bis = 10 -%}{%- endif -%}
        {%- set wt = namespace(i=none) -%}
        {%- for w in wochentage -%}{%- if w | lower in satz -%}{%- set wt.i = loop.index0 -%}{%- endif -%}{%- endfor -%}
        {%- set wd = heute.weekday() -%}
        {%- if 'wochenende' in satz -%}
          {%- set sa = heute + timedelta(days=5 - wd) -%}
          {%- set ziele = [heute] if wd == 6 else [sa, sa + timedelta(days=1)] -%}
        {%- elif wt.i is not none -%}
          {%- set ziele = [heute + timedelta(days=(wt.i - wd) % 7)] -%}
        {%- elif 'übermorgen' in satz -%}
          {%- set ziele = [heute + timedelta(days=2)] -%}
        {%- elif 'morgen' in satz_tag and 'heute' not in satz -%}
          {%- set ziele = [heute + timedelta(days=1)] -%}
        {%- else -%}
          {%- set ziele = [heute] -%}
        {%- endif -%}
        {#- 2) Daten je Tag sammeln. Stundenwerte sind genauer: mit Tageszeit nur deren Fenster, sonst heute der Rest des Tages bzw. 7 bis 21 Uhr -#}
        {%- for z in ziele -%}
          {%- set t = namespace(f=none) -%}
          {%- for f in tage -%}
            {%- if t.f is none and (f.datetime | as_datetime | as_local).date() == z -%}{%- set t.f = f -%}{%- endif -%}
          {%- endfor -%}
          {%- if t.f is not none -%}
            {%- set f = t.f -%}
            {%- set diff = (z - heute).days -%}
            {%- set label = ['heute', 'morgen', 'übermorgen'][diff] if diff < 3 and ziele | count == 1 else 'am ' ~ wochentage[z.weekday()] -%}
            {#- Tageszeit heute schon vorbei? Dann kurz sagen und normal mit dem Rest des Tages antworten -#}
            {%- set vorbei = tz.name is not none and diff == 0 and now().hour >= tz.bis -%}
            {%- if vorbei -%}{%- set ns.s = ns.s + [gross(label ~ ' ' ~ tz.name) ~ ' ist schon vorbei.'] -%}{%- endif -%}
            {%- set tzn = none if vorbei else tz.name -%}
            {%- set h = namespace(n=0, p=none, uv=none, c=[], t=[]) -%}
            {%- for s in stunden -%}
              {%- set d = s.datetime | as_datetime | as_local -%}
              {%- if (tzn is none and d.date() == z and (diff == 0 or 7 <= d.hour <= 21)) or (tzn is not none and ((d.date() == z and tz.von <= d.hour < tz.bis) or (tz.bis > 24 and d.date() == z + timedelta(days=1) and d.hour < tz.bis - 24))) -%}
                {%- set h.n = h.n + 1 -%}
                {%- set h.t = h.t + [s.temperature | float(0)] -%}
                {%- set h.c = h.c + [s.condition | default('')] -%}
                {%- if s.precipitation_probability is defined -%}{%- set h.p = [h.p if h.p is not none else 0, s.precipitation_probability | float(0)] | max -%}{%- endif -%}
                {%- if s.uv_index is defined -%}{%- set h.uv = [h.uv if h.uv is not none else 0, s.uv_index | float(0)] | max -%}{%- endif -%}
              {%- endif -%}
            {%- endfor -%}
            {#- Tageszeit-Fenster nur, wenn es dafuer Stundenwerte gibt (reichen meist ~48 h), sonst Rueckfall auf den ganzen Tag -#}
            {%- set fenster = tzn is not none and h.n > 0 -%}
            {%- if fenster -%}{%- set label = (label ~ tz.name | lower) if diff >= 3 and tz.name not in ['früh', 'Nacht'] else (label ~ (' in der Nacht' if diff >= 3 and tz.name == 'Nacht' else ' ' ~ tz.name)) -%}{%- endif -%}
            {%- set p = h.p if h.p is not none else (f.precipitation_probability | float(0) if f.precipitation_probability is defined else none) -%}
            {%- set uv = h.uv if h.uv is not none else (f.uv_index | float(0) if f.uv_index is defined else none) -%}
            {%- if diff == 0 and not fenster and sensor_uv and has_value(sensor_uv) -%}{%- set uv = [uv if uv is not none else 0, states(sensor_uv) | float(0)] | max -%}{%- endif -%}
            {#- Wetterlage: haeufigste Lage der betrachteten Stunden, sonst die des ganzen Tages -#}
            {%- set m = namespace(c=f.condition, n=0) -%}
            {%- if h.n >= (1 if fenster else 3) -%}
              {%- for c in h.c | unique -%}
                {%- set k = h.c | select('eq', c) | list | count -%}
                {%- if k > m.n -%}{%- set m.n = k -%}{%- set m.c = c -%}{%- endif -%}
              {%- endfor -%}
            {%- endif -%}
            {#- Viel Regen angesagt, aber die haeufigste Stunden-Lage ist trocken: dann die nasse Tages-Lage nennen -#}
            {%- if p is not none and p >= regen_wahrscheinlich_ab and m.c not in nass and f.condition in nass -%}{%- set m.c = f.condition -%}{%- endif -%}
            {%- set ns.d = ns.d + [{'label': label, 'diff': diff, 'lage': m.c, 'temp': f.temperature, 'templow': none if fenster else f.templow | default(none), 'fenster': fenster, 'tmin': h.t | min if h.t else none, 'tmax': h.t | max if h.t else none}] -%}
            {%- if p is not none -%}{%- set ns.ps = ns.ps + [p] -%}{%- endif -%}
            {%- if uv is not none -%}{%- set ns.uvs = ns.uvs + [uv] -%}{%- endif -%}
            {%- set ns.ts = ns.ts + [(h.t | max) if fenster else f.temperature | float(0)] -%}
            {%- if m.c in nass or (f.precipitation | default(0) | float(0)) >= 0.5 and h.n == 0 -%}{%- set ns.nass = true -%}{%- endif -%}
            {%- set ns.boe = [ns.boe, f.wind_gust_speed | default(0) | float(0)] | max -%}
          {%- endif -%}
        {%- endfor -%}
        {%- if ns.d | count == 0 -%}
          {%- set ns.s = ns.s + ['Dafür habe ich leider noch keine Vorhersage bekommen.'] -%}
        {%- else -%}
          {%- set einzel = ns.d | count == 1 -%}
          {%- set ist_heute = einzel and ns.d[0].diff == 0 and not ns.d[0].fenster -%}
          {%- set wann = ns.d[0].label if einzel else 'am Wochenende' -%}
          {%- set p = ns.ps | max if ns.ps else none -%}
          {%- set uv = ns.uvs | max if ns.uvs else none -%}
          {%- set tmin = ns.ts | min -%}
          {#- 3) Gezielte Frage zuerst beantworten -#}
          {%- if frage in ['regen', 'schirm'] -%}
            {%- set ns.s = ns.s + ['Ja, es regnet gerade.' if ist_heute and regnet_jetzt else regen_satz(p, ns.nass, wann, frage)] -%}
          {%- elif frage == 'jacke' -%}
            {%- if tmin < jacke_unter -%}
              {%- set ns.s = ns.s + ['Ja, bei höchstens ' ~ zahl(tmin) ~ ' Grad solltest du ' ~ wann ~ ' eine Jacke anziehen.'] -%}
            {%- elif tmin < jacke_unter + 6 -%}
              {%- set ns.s = ns.s + ['Eine leichte Jacke reicht, es werden ' ~ wann ~ ' bis zu ' ~ zahl(tmin) ~ ' Grad.'] -%}
            {%- else -%}
              {%- set ns.s = ns.s + ['Nein, bei bis zu ' ~ zahl(tmin) ~ ' Grad brauchst du ' ~ wann ~ ' keine Jacke.'] -%}
            {%- endif -%}
            {%- if (p is not none and p >= regen_wahrscheinlich_ab) or (p is none and ns.nass) -%}
              {%- set ns.s = ns.s + ['Wegen des Regens nimmst du am besten eine Regenjacke.'] -%}
            {%- endif -%}
          {%- elif frage in ['sonne', 'uv'] -%}
            {%- if uv is none -%}
              {%- set ns.s = ns.s + ['Zum UV-Index liefert mein Wetterdienst leider keine Werte.'] -%}
            {%- elif uv >= uv_schwelle -%}
              {%- set ns.s = ns.s + [('Ja, der' if frage == 'sonne' else 'Der') ~ ' UV-Index erreicht ' ~ wann ~ ' ' ~ zahl(uv) ~ ', denk an Sonnencreme' ~ (' und ' ~ kopfbedeckung if uv >= uv_schwelle_kopfbedeckung else '') ~ '.'] -%}
            {%- else -%}
              {%- set ns.s = ns.s + [('Nein, der' if frage == 'sonne' else 'Der') ~ ' UV-Index erreicht ' ~ wann ~ ' höchstens ' ~ zahl(uv) ~ ', Sonnencreme brauchst du normalerweise nicht.'] -%}
            {%- endif -%}
          {%- endif -%}
          {#- 4) Kontext: die Vorhersage selbst -#}
          {%- if ist_heute and frage == 'allgemein' and temp_jetzt is not none -%}
            {%- set ns.s = ns.s + ['Aktuell sind es ' ~ zahl(temp_jetzt) ~ ' Grad.'] -%}
          {%- endif -%}
          {%- set teile = namespace(l=[]) -%}
          {%- for d in ns.d -%}
            {%- set verb = ('bleibt' if d.diff == 0 and now().hour >= 17 and not d.fenster else 'wird') ~ ' es ' if loop.first else '' -%}
            {%- set nacht = (', in der Nacht geht es runter auf ' ~ zahl(d.templow) ~ ' Grad') if einzel and d.templow is not none else '' -%}
            {%- set teile.l = teile.l + [d.label ~ ' ' ~ verb ~ txt.get(d.lage, d.lage) ~ (((' bei rund ' ~ zahl(d.tmax)) if zahl(d.tmin) == zahl(d.tmax) else (' bei ' ~ zahl(d.tmin) ~ ' bis ' ~ zahl(d.tmax))) if d.fenster else (' bei bis zu ' ~ zahl(d.temp))) ~ ' Grad' ~ nacht] -%}
          {%- endfor -%}
          {%- set ns.s = ns.s + [gross(teile.l | join(', ')) ~ '.'] -%}
          {#- 5) Hinweise nur beim allgemeinen Wetterbericht -#}
          {%- if frage == 'allgemein' -%}
            {%- if ist_heute and regnet_jetzt -%}
              {%- set ns.s = ns.s + ['Es regnet gerade, nimm einen Regenschirm mit.'] -%}
            {%- else -%}
              {%- set r = regen_satz(p, ns.nass, wann, frage) -%}
              {%- if r | trim -%}{%- set ns.s = ns.s + [r | trim] -%}{%- endif -%}
            {%- endif -%}
            {%- if uv is not none and uv >= uv_schwelle -%}
              {%- set ns.s = ns.s + ['Der UV-Index erreicht ' ~ zahl(uv) ~ ', denk an Sonnencreme' ~ (' und ' ~ kopfbedeckung if uv >= uv_schwelle_kopfbedeckung else '') ~ '.'] -%}
            {%- endif -%}
            {%- if tmin < kalt_unter -%}
              {%- set ns.s = ns.s + ['Zieh dich warm an, Mütze und Handschuhe schaden nicht.'] -%}
            {%- endif -%}
            {%- if ns.boe >= boeen_ab -%}
              {%- set ns.s = ns.s + ['Dazu wird es stürmisch mit Böen bis ' ~ zahl(ns.boe) ~ ' Kilometer pro Stunde.'] -%}
            {%- endif -%}
          {%- endif -%}
        {%- endif -%}
      {%- else -%}
        {%- for f in tage[:7] -%}
          {%- set d = (f.datetime | as_datetime | as_local).date() -%}
          {%- set name = 'heute' if d == heute else ('morgen' if d == heute + timedelta(days=1) else 'am ' ~ wochentage[d.weekday()]) -%}
          {%- set t = f.temperature | float(0) -%}
          {%- if ns.max is none or t > ns.max -%}{%- set ns.max = t -%}{%- set ns.warm = name -%}{%- endif -%}
          {%- if ns.min is none or t < ns.min -%}{%- set ns.min = t -%}{%- endif -%}
          {%- if f.templow is defined and f.templow is not none and (ns.nacht is none or f.templow | float(0) < ns.nacht) -%}{%- set ns.nacht = f.templow | float(0) -%}{%- endif -%}
          {%- if (f.condition | default('')) in nass -%}{%- set ns.regentage = ns.regentage + [name] -%}{%- endif -%}
        {%- endfor -%}
        {%- if ns.max is none -%}
          {%- set ns.s = ns.s + ['Für die nächsten Tage habe ich leider keine Vorhersage bekommen.'] -%}
        {%- else -%}
          {%- if zahl(ns.min) == zahl(ns.max) -%}
            {%- set ns.s = ns.s + ['In den nächsten Tagen liegen die Höchstwerte bei rund ' ~ zahl(ns.max) ~ ' Grad.'] -%}
          {%- else -%}
            {%- set ns.s = ns.s + ['In den nächsten Tagen liegen die Höchstwerte zwischen ' ~ zahl(ns.min) ~ ' und ' ~ zahl(ns.max) ~ ' Grad, am wärmsten wird es ' ~ ns.warm ~ '.'] -%}
          {%- endif -%}
          {%- if ns.nacht is not none -%}{%- set ns.s = ns.s + ['Nachts kühlt es auf bis zu ' ~ zahl(ns.nacht) ~ ' Grad ab.'] -%}{%- endif -%}
          {%- if ns.regentage | count == 0 -%}
            {%- set ns.s = ns.s + ['Es bleibt voraussichtlich trocken.'] -%}
          {%- elif ns.regentage | count >= 5 -%}
            {%- set ns.s = ns.s + ['Es wird wechselhaft, an den meisten Tagen musst du mit Regen rechnen.'] -%}
          {%- else -%}
            {%- set ns.s = ns.s + ['Mit Regen musst du ' ~ liste(ns.regentage) ~ ' rechnen.'] -%}
          {%- endif -%}
        {%- endif -%}
      {%- endif -%}
      {{- ns.s | join(' ') -}}
mode: queued
max: 3
Laufen: Wann soll ich heute laufen gehen?
Was sie kann: Sucht aus der Stundenvorhersage die beste Startzeit für deine Runde heute oder morgen, sodass du vor Sonnenuntergang zurück bist, und sagt dir Temperatur, Wetter und Rückkehrzeit dazu. Ist selbst das beste Zeitfenster zu nass, zu heiß oder zu kalt, empfiehlt sie das Fitnessstudio.
Beispielsätze: „Wann soll ich heute laufen gehen?“, „Lohnt es sich, morgen joggen zu gehen?“
Du brauchst: eine Wetter-Integration mit Stundenvorhersage inklusive gefühlter Temperatur, optional eine eigene Wetterstation und einen Datums-Helfer für deinen letzten Lauf.
Besonderheiten: Bewertet wird nicht die Lufttemperatur, sondern eine gefühlte Lauftemperatur zur Mitte der Runde: die gefühlte Temperatur der Vorhersage, korrigiert mit der eigenen Wetterstation, plus Sonne und minus Wind. So gewinnt im Herbst die warme, sonnige Zeit und im Hochsommer die kühlere. Den Hinweis „Dein letzter Lauf ist übrigens 6 Tage her“ aus dem Video liefert ein Datums-Helfer, den bei mir eine zweite Automation über die Trainingsminuten der Apple Watch pflegt. Die ist hier nicht enthalten.
Anpassen: Alles steht in Variablen (hier anpassen): Dauer der Runde, Wohlfühltemperatur, früheste Startzeit, Sonnen- und Windfaktoren. Bei mir liegt das Dorf im Tal, deshalb ist die Sonne schon 50 Minuten vor dem offiziellen Sonnenuntergang weg.
alias: Laufen - Beste Zeit per Sprache
description: |-
  Beantwortet 'Wann soll ich heute (oder morgen) laufen gehen?' lokal per Assist.

  PRINZIP: Jede mögliche Startzeit (Stundenvorhersage plus 'jetzt gleich'), bei der die Runde vor Sonnenuntergang endet, bekommt Punkte. Entscheidend ist nicht die Lufttemperatur, sondern eine GEFÜHLTE LAUFTEMPERATUR für die Mitte der Runde:
    gefühlte Temperatur des Wetterdienstes
    + Stationskorrektur (nur heute: Differenz GEFÜHLTE Temperatur der eigenen Wetterstation zur gefühlten Temperatur der Vorhersage jetzt; wer nur einen normalen Temperatursensor hat, trägt den ein, klingt über 6 Stunden ab – fängt ein, dass es im Tal kühler ist als vorhergesagt)
    + Sonnenbonus (bis 'sonnen_plus_grad', weniger bei Wolken, läuft in den 2 Stunden aus, bevor die Sonne WEG ist – im Tal ist das 'sonne_weg_min_vor_sonnenuntergang' vor dem offiziellen Sonnenuntergang; morgens entsprechend)
    - Windabzug.
  Der Abstand dieser gefühlten Temperatur zur Wohlfühltemperatur kostet Punkte (zu kalt mehr als zu warm), dazu Regenwahrscheinlichkeit, Hitze und hoher UV-Index. So gewinnt im Herbst/Winter die sonnige, warme Zeit und im Hochsommer die kühlere. Optional gibt es einen Bonus für den Start zur goldenen Stunde (bei Simon 0, weil die Abendsonne im Tal zu früh weg ist). Ist selbst das beste Fenster zu nass, zu heiß oder zu kalt, kommt die Empfehlung fürs Fitnessstudio.

  ANPASSEN: Alles Persönliche steht in der ersten Aktion 'Variablen (hier anpassen)'.

  Wohlfühltemperatur bei Simon 21,5 Grad: am 18.09.2026 bei gemessenen 20,4 Grad als 'einen Tick zu kühl' empfunden, daher aktuelle Temperatur plus 1. Ist 'sensor_zuletzt_gelaufen' gesetzt, nennt die Antwort ab 'letzter_lauf_hinweis_ab_tagen' Tagen, wie lange der letzte Lauf her ist.
triggers:
  - trigger: conversation
    id: laufen
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann (soll|sollte|kann|könnte) ich [(heute|morgen)] [am besten] (laufen|joggen|rennen) [gehen]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann ich [(heute|morgen)] [am besten] (laufen|joggen|rennen) [gehen] (soll|sollte|kann|könnte)'
      - wann gehe ich [(heute|morgen)] am besten (laufen|joggen)
      - wann ist [(heute|morgen)] die beste Zeit (zum|fürs) (Laufen|Joggen) [(heute|morgen)]
      - (soll|sollte|kann) ich (heute|morgen) (laufen|joggen) [gehen]
      - lohnt es sich (heute|morgen) (laufen|joggen) zu gehen
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      wetter_entity: weather.openweathermap
      sensor_temperatur: sensor.wetterstation_apparent_temperature
      dauer_min: 50
      fruehestens_uhr: 7
      wohlfuehl_temp: 21.5
      punkte_pro_grad_zu_kalt: 4
      punkte_pro_grad_zu_warm: 3
      zu_heiss_ab: 26
      sonnen_plus_grad: 4
      sonne_weg_min_vor_sonnenuntergang: 50
      wind_abzug_grad_pro_kmh: 0.1
      goldene_stunde_bonus: 0
      goldene_stunde_min_vor_sonnenuntergang: 60
      goldene_stunde_start_offset_min: -40
      abzug_pro_minute_nach_idealstart: 0.5
      fitnessstudio_alternative: true
      studio_ab_regen_prozent: 50
      studio_ab_grad: 32
      studio_unter_grad: -8
      sensor_zuletzt_gelaufen: input_datetime.simon_zuletzt_gelaufen
      letzter_lauf_hinweis_ab_tagen: 3
  - alias: Stundenvorhersage holen
    action: weather.get_forecasts
    target:
      entity_id: '{{ wetter_entity }}'
    data:
      type: hourly
    response_variable: antwort_stunden
    continue_on_error: true
  - alias: Vorhersage als Liste bereitstellen
    variables:
      stunden: '{{ antwort_stunden[wetter_entity].forecast if antwort_stunden is defined and wetter_entity in antwort_stunden else [] }}'
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- set txt = {'sunny': 'sonnig', 'clear-night': 'klar', 'partlycloudy': 'teils bewölkt', 'cloudy': 'bewölkt', 'rainy': 'regnerisch', 'pouring': 'sehr nass', 'fog': 'neblig', 'snowy': 'verschneit', 'snowy-rainy': 'nasskalt', 'lightning': 'gewittrig', 'lightning-rainy': 'gewittrig', 'hail': 'hagelig', 'windy': 'windig', 'windy-variant': 'windig', 'exceptional': 'außergewöhnlich'} -%}
      {%- set nass = ['rainy', 'pouring', 'lightning-rainy', 'snowy-rainy', 'snowy', 'hail'] -%}
      {%- macro zahl(v) -%}{%- set r = v | float(0) | round(0) | int -%}{{ 'minus ' ~ (r | abs) if r < 0 else r }}{%- endmacro -%}
      {%- macro uhr(d) -%}{{ d.hour }} Uhr{{ ' ' ~ d.minute if d.minute else '' }}{%- endmacro -%}
      {%- set satz = trigger.sentence | lower -%}
      {%- set jetzt = now() -%}
      {%- set dauer = timedelta(minutes=dauer_min) -%}
      {%- set su = state_attr('sun.sun', 'next_setting') | as_datetime | as_local -%}
      {%- set sa = state_attr('sun.sun', 'next_rising') | as_datetime | as_local -%}
      {#- Stationskorrektur: wie weit liegt die eigene Messung gerade neben der Vorhersage? -#}
      {%- set delta = ([[states(sensor_temperatur) | float(0) - (stunden[0].apparent_temperature | default(stunden[0].temperature)) | float(0), -5] | max, 5] | min) if sensor_temperatur and has_value(sensor_temperatur) and stunden | count > 0 else 0 -%}
      {%- set best = namespace(sc=none, start=none, f=none, gold=false, p=0, tag=0, su=none, gef=0, sonne=0) -%}
      {#- Erst den gefragten Tag pruefen; gibt es heute kein Fenster mehr, automatisch morgen -#}
      {%- for tag in ([1] if 'morgen' in satz else [0, 1]) -%}
        {%- if best.sc is none -%}
          {%- set D = jetzt.date() + timedelta(days=tag) -%}
          {#- next_setting/next_rising zeigen auf das NAECHSTE Ereignis; auf den Zieltag verschieben (Minutenabweichung egal) -#}
          {%- set su_d = su + timedelta(days=(D - su.date()).days) -%}
          {%- set sa_d = sa + timedelta(days=(D - sa.date()).days) -%}
          {%- set sonne_weg = su_d - timedelta(minutes=sonne_weg_min_vor_sonnenuntergang) -%}
          {%- set sonne_da = sa_d + timedelta(minutes=sonne_weg_min_vor_sonnenuntergang) -%}
          {%- set g = su_d - timedelta(minutes=goldene_stunde_min_vor_sonnenuntergang) + timedelta(minutes=goldene_stunde_start_offset_min) -%}
          {%- set gold = g.replace(minute=g.minute - g.minute % 5, second=0, microsecond=0) -%}
          {%- set jr = (jetzt + timedelta(minutes=5 - jetzt.minute % 5)).replace(second=0, microsecond=0) -%}
          {%- set k = namespace(l=[]) -%}
          {%- for s in stunden -%}
            {%- set d = s.datetime | as_datetime | as_local -%}
            {%- if tag == 0 and loop.first and jr + dauer <= su_d -%}{%- set k.l = k.l + [{'start': jr, 'f': s, 'gold': false}] -%}{%- endif -%}
            {%- if d.date() == D -%}
              {%- if d > jetzt and d.hour >= fruehestens_uhr and d + dauer <= su_d -%}{%- set k.l = k.l + [{'start': d, 'f': s, 'gold': false}] -%}{%- endif -%}
              {%- if goldene_stunde_bonus > 0 and d.hour == gold.hour and gold > jetzt and gold + dauer <= su_d -%}{%- set k.l = k.l + [{'start': gold, 'f': s, 'gold': true}] -%}{%- endif -%}
            {%- endif -%}
          {%- endfor -%}
          {%- for c in k.l -%}
            {%- set f = c.f -%}
            {%- set p = f.precipitation_probability | float(0) if f.precipitation_probability is defined else (70 if (f.condition | default('')) in nass else 0) -%}
            {#- Gefuehlte Lauftemperatur zur Mitte der Runde -#}
            {%- set mitte = c.start + timedelta(minutes=dauer_min / 2) -%}
            {%- set basis = f.apparent_temperature | float(0) if f.apparent_temperature is defined else f.temperature | float(0) -%}
            {%- set voraus = (c.start - jetzt).total_seconds() / 3600 -%}
            {%- set korrektur = delta * ([1 - voraus / 6, 0] | max) if tag == 0 else 0 -%}
            {%- set f_abend = [[(sonne_weg - mitte).total_seconds() / 7200, 0] | max, 1] | min -%}
            {%- set f_morgen = [[(mitte - sonne_da).total_seconds() / 7200, 0] | max, 1] | min -%}
            {%- set sonne = sonnen_plus_grad * (1 - (f.cloud_coverage | default(50) | float(50)) / 100) * ([f_abend, f_morgen] | min) -%}
            {%- set gef = basis + korrektur + sonne - (f.wind_speed | default(0) | float(0)) * wind_abzug_grad_pro_kmh -%}
            {%- set diff = gef - wohlfuehl_temp -%}
            {%- set temp_abzug = (0 - diff) * punkte_pro_grad_zu_kalt if diff < 0 else diff * punkte_pro_grad_zu_warm -%}
            {%- set gold_teil = ((goldene_stunde_bonus if c.gold else 0) - ([(c.start - gold).total_seconds() / 60, 0] | max) * abzug_pro_minute_nach_idealstart) if goldene_stunde_bonus > 0 else 0 -%}
            {%- set sc = 100 - p * 0.8 - temp_abzug - ([gef - zu_heiss_ab, 0] | max) * 5 - (10 if (f.uv_index | default(0) | float(0)) >= 6 else 0) + gold_teil -%}
            {%- if best.sc is none or sc > best.sc -%}
              {%- set best.sc = sc -%}{%- set best.start = c.start -%}{%- set best.f = f -%}{%- set best.gold = c.gold -%}{%- set best.p = p -%}{%- set best.tag = tag -%}{%- set best.su = su_d -%}{%- set best.gef = gef -%}{%- set best.sonne = sonne -%}
            {%- endif -%}
          {%- endfor -%}
        {%- endif -%}
      {%- endfor -%}
      {%- set ns = namespace(s=[]) -%}
      {%- if best.sc is none -%}
        {%- set ns.s = ns.s + ['Ich finde gerade kein passendes Zeitfenster bei Tageslicht' ~ (', vielleicht ist heute ein Tag fürs Fitnessstudio.' if fitnessstudio_alternative else '.')] -%}
      {%- else -%}
        {%- set wann = 'heute' if best.tag == 0 else 'morgen' -%}
        {%- set t = best.f.temperature | float(0) -%}
        {%- if best.tag == 1 and 'morgen' not in satz -%}
          {%- set ns.s = ns.s + ['Heute klappt es bei Tageslicht nicht mehr.'] -%}
        {%- endif -%}
        {%- if fitnessstudio_alternative and (best.p >= studio_ab_regen_prozent or best.gef >= studio_ab_grad or best.gef < studio_unter_grad) -%}
          {%- set grund = ('liegt die Regenwahrscheinlichkeit bei ' ~ zahl(best.p) ~ ' Prozent') if best.p >= studio_ab_regen_prozent else ('fühlt es sich an wie ' ~ zahl(best.gef) ~ ' Grad') -%}
          {%- set ns.s = ns.s + ['Draußen wird das ' ~ wann ~ ' nichts: Selbst im besten Fenster um ' ~ uhr(best.start) ~ ' ' ~ grund ~ '. Geh lieber ins Fitnessstudio.'] -%}
        {%- else -%}
          {%- set ns.s = ns.s + ['Am besten läufst du ' ~ ('jetzt gleich los, um ' ~ uhr(best.start) if best.tag == 0 and best.start - jetzt < timedelta(minutes=10) else wann ~ ' um ' ~ uhr(best.start) ~ ' los') ~ (', pünktlich zur goldenen Stunde' if best.gold else '') ~ '.'] -%}
          {%- set regen = 'es bleibt trocken' if best.p < 20 else ('mit ' ~ zahl(best.p) ~ ' Prozent Regenwahrscheinlichkeit bleibt es vermutlich trocken') -%}
          {%- set gefuehl = (', gefühlt eher ' ~ zahl(best.gef) ~ (' dank Sonne' if best.sonne >= 1.5 and best.gef > t else '')) if (best.gef - t) | abs >= 2 else '' -%}
          {%- set ns.s = ns.s + ['Zu der Zeit sind es etwa ' ~ zahl(t) ~ ' Grad' ~ gefuehl ~ ', es ist ' ~ txt.get(best.f.condition, best.f.condition) ~ ' und ' ~ regen ~ '.'] -%}
          {%- set ns.s = ns.s + ['Zurück bist du gegen ' ~ uhr(best.start + dauer) ~ ((', die Sonne geht um ' ~ uhr(best.su) ~ ' unter') if best.su - (best.start + dauer) < timedelta(hours=2) else '') ~ '.'] -%}
        {%- endif -%}
      {%- endif -%}
      {#- Optionaler Hinweis, wie lange der letzte Lauf her ist -#}
      {%- if sensor_zuletzt_gelaufen and has_value(sensor_zuletzt_gelaufen) -%}
        {%- set her = (jetzt.date() - (states(sensor_zuletzt_gelaufen) | as_datetime | as_local).date()).days -%}
        {%- if her >= letzter_lauf_hinweis_ab_tagen and her < 365 -%}{%- set ns.s = ns.s + ['Dein letzter Lauf ist übrigens ' ~ her ~ ' Tage her.'] -%}{%- endif -%}
      {%- endif -%}
      {{- ns.s | join(' ') -}}
mode: queued
max: 3
Haus-Check: Ist alles zu? Wer ist zu Hause?
Was sie kann: „Ist alles zu?“ nennt nur die Abweichungen: offene Fenster und Türen, offene Garagentore und Sensoren, die sich nicht melden. „Wer ist zu Hause?“ geht dynamisch alle Personen durch.
Beispielsätze: „Ist alles zu?“, „Kann ich ins Bett gehen?“, „Wer ist gerade zu Hause?“
Du brauchst: Tür- und Fensterkontakte, optional Garagentore als Cover und die Personen-Entitäten.
Besonderheiten: Bewusst nur echte Kontaktsensoren und nicht die „Fensterstatus“-Sensoren mancher Thermostate, die ein offenes Fenster nur aus dem Temperaturabfall erraten. Das Schloss der Wohnungstür prüft die Automation absichtlich nicht, nur ob die Tür zu ist.
Anpassen: In Variablen (hier anpassen) die Kontakte und Garagentore mit dem Text, wie sie genannt werden sollen. Optional Geräte, die beim Gehen aus sein sollten.
alias: Haus - Alles zu und wer ist da per Sprache
description: |-
  Zwei lokale Assist-Fragen: (1) Haus-Check 'Ist alles zu?' / 'Kann ich ins Bett gehen?' – nennt nur Abweichungen: offene Fenster/Türen, offene Garagentore, noch eingeschaltete Geräte und Sensoren ohne Rückmeldung. (2) 'Wer ist zu Hause?' – alle Personen-Entitäten, dynamisch.

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)'. 'oeffnungen' = echte Kontaktsensoren (on = offen) mit dem Text, wie sie genannt werden sollen; bewusst NICHT die 'Fensterstatus'-Sensoren der Thermostate, die nur aus dem Temperaturabfall raten. 'garagen' = Cover (alles außer closed gilt als offen). 'geraete' = optional Schalter, die nachts/beim Gehen aus sein sollten (Format: entity_id: 'der Backofen'); bei Simon bewusst leer. Das Schloss der Wohnungstür wird absichtlich nicht geprüft, nur ob die Tür zu ist.
triggers:
  - trigger: conversation
    id: check
    command:
      - ist [(jetzt|noch|auch)] alles (zu|geschlossen|dicht|sicher)
      - (ist|sind) [noch] (alle|irgendwelche|irgendein|ein) (Fenster|Türen|Tür|Fenster und Türen|Fenster oder Türen) (zu|geschlossen|offen|auf)
      - ist [noch] (irgendwo|irgendwas|irgendetwas|etwas|was) (offen|auf)
      - (steht|stehen) [noch] (irgendwo|irgendwelche|ein) [(Fenster|Türen)] (offen|auf)
      - kann ich [jetzt] (ins Bett [gehen]|schlafen [gehen]|gehen|los|losfahren|das Haus verlassen|die Wohnung verlassen)
      - (sind|ist) (die Garagen|die Garagentore|die Garage|das Garagentor) (zu|geschlossen|offen|auf)
      - (Haus-Check|Haus Check|Hauscheck|Sicherheitscheck)
  - trigger: conversation
    id: wer
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wer [ist] [(gerade|aktuell|alles|noch|jetzt)] (zu Hause|zuhause|daheim|da) [ist]'
      - ist [(gerade|aktuell|noch)] (jemand|wer|einer|keiner|niemand) (zu Hause|zuhause|daheim|da)
      - wer ist [(gerade|aktuell)] (unterwegs|nicht da|nicht zu Hause|weg)
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      oeffnungen:
        binary_sensor.wohnungstur_1_og_contact: die Wohnungstür
        binary_sensor.lock_ultra_50_tur: die Haustür
        binary_sensor.balkontur_studio: die Balkontür im Studio
        binary_sensor.fenster_studio_contact: das Fenster im Studio
        binary_sensor.balkontur_schlafzimmer: die Balkontür im Schlafzimmer
        binary_sensor.fenster_schlafzimmer_1_og_contact: das Fenster im Schlafzimmer
        binary_sensor.balkontur_wohnzimmer: die Balkontür im Wohnzimmer
        binary_sensor.fenster_kinderzimmer: das Fenster im Kinderzimmer
      garagen:
        cover.garagentor_og: das Garagentor im ersten OG
        cover.garagentor_dg: das Garagentor im DG
      geraete: {}
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- macro liste(l) -%}{%- if l | count > 1 -%}{{ l[:-1] | join(', ') }} und {{ l[-1] }}{%- else -%}{{ l | join('') }}{%- endif -%}{%- endmacro -%}
      {%- set ns = namespace(s=[], offen=[], stumm=[], an=[], da=[], weg=[]) -%}
      {%- if trigger.id == 'check' -%}
        {%- for e, t in oeffnungen.items() -%}
          {%- if not has_value(e) -%}{%- set ns.stumm = ns.stumm + [t] -%}{%- elif is_state(e, 'on') -%}{%- set ns.offen = ns.offen + [t] -%}{%- endif -%}
        {%- endfor -%}
        {%- for e, t in garagen.items() -%}
          {%- if not has_value(e) -%}{%- set ns.stumm = ns.stumm + [t] -%}{%- elif not is_state(e, 'closed') -%}{%- set ns.offen = ns.offen + [t] -%}{%- endif -%}
        {%- endfor -%}
        {%- for e, t in geraete.items() -%}
          {%- if is_state(e, 'on') -%}{%- set ns.an = ns.an + [t] -%}{%- endif -%}
        {%- endfor -%}
        {%- if ns.offen | count == 0 -%}
          {%- set ns.s = ns.s + [('Alles zu: ' if ns.an | count == 0 and ns.stumm | count == 0 else '') ~ 'Fenster, Türen und Garagentore sind geschlossen.'] -%}
        {%- else -%}
          {%- set ns.s = ns.s + ['Noch offen ' ~ ('ist ' if ns.offen | count == 1 else 'sind ') ~ liste(ns.offen) ~ '.'] -%}
        {%- endif -%}
        {%- if ns.an | count > 0 -%}
          {%- set ns.s = ns.s + ['Eingeschaltet ' ~ ('ist' if ns.an | count == 1 else 'sind') ~ ' noch ' ~ liste(ns.an) ~ '.'] -%}
        {%- endif -%}
        {%- if ns.stumm | count > 0 -%}
          {%- set ns.s = ns.s + ['Keine Rückmeldung bekomme ich von ' ~ liste(ns.stumm) | replace('die ', 'der ', 1) | replace('das ', 'dem ', 1) ~ '.'] -%}
        {%- endif -%}
      {%- else -%}
        {%- for p in states.person -%}
          {%- set vorname = p.name.split(' ')[0] -%}
          {%- if p.state == 'home' -%}{%- set ns.da = ns.da + [vorname] -%}{%- elif p.state not in ['unknown', 'unavailable'] -%}{%- set ns.weg = ns.weg + [vorname] -%}{%- endif -%}
        {%- endfor -%}
        {%- if ns.da | count == 0 -%}
          {%- set ns.s = ns.s + ['Gerade ist niemand zu Hause.'] -%}
        {%- elif ns.da | count == 1 -%}
          {%- set ns.s = ns.s + ['Zu Hause ist gerade nur ' ~ ns.da[0] ~ '.'] -%}
        {%- else -%}
          {%- set ns.s = ns.s + ['Zu Hause sind gerade ' ~ liste(ns.da) ~ '.'] -%}
        {%- endif -%}
        {%- if ns.weg | count > 0 and ns.da | count > 0 -%}
          {%- set ns.s = ns.s + ['Unterwegs ' ~ ('ist ' if ns.weg | count == 1 else 'sind ') ~ liste(ns.weg) ~ '.'] -%}
        {%- endif -%}
      {%- endif -%}
      {{- ns.s | join(' ') -}}
mode: queued
max: 3
Wo ist …? Standort und Fahrzeit nach Hause
Was sie kann: Sagt, ob jemand zu Hause ist, in welcher Zone er gerade ist oder, wenn er unterwegs ist, in welchem Ort und welcher Straße. Fährt die Person gerade Auto, heißt es „mit dem Auto unterwegs“, dazu kommt die aktuelle Fahrzeit nach Hause.
Beispielsätze: „Wo ist Arabella gerade?“, „Ist Simon schon zu Hause?“, „Wie lange braucht Arabella noch nach Hause?“
Du brauchst: Personen mit der Home Assistant App (Standort- und Aktivitätssensor) und für die Fahrzeit die Integration Waze Travel Time.
Besonderheiten: Die Vornamen stehen bewusst fest in den Trigger-Sätzen und nicht als Platzhalter. Sonst würde die Automation jede „Wo ist …“-Frage abfangen, auch „Wo ist der Eiffelturm?“, und die käme nie mehr beim Sprachmodell an. Ist der Standort älter als 30 Minuten, sagt die Antwort das dazu.
Anpassen: Pro Person ein Eintrag in Variablen (hier anpassen) (Schlüssel = Vorname klein geschrieben) und die Vornamen zusätzlich in den Trigger-Sätzen.
alias: Personen - Wo ist ... per Sprache
description: |-
  Beantwortet lokal per Assist 'Wo ist Arabella gerade?', 'Ist Simon schon zu Hause?' oder 'Wann ist Arabella zu Hause?'. Antwort: zu Hause, der Name der Zone oder – unterwegs – Ort und Straße aus dem Standort-Sensor der Companion-App. Meldet der Aktivitäts-Sensor 'Automotive', heißt es 'mit dem Auto unterwegs'. Dazu die Fahrzeit nach Hause aus der Waze-Travel-Time-Integration (wird vor der Antwort aktualisiert).

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)'. Pro Person ein Eintrag (Schlüssel = Vorname klein geschrieben, so wie er im Satz vorkommt); 'ort', 'aktivitaet' und 'fahrzeit' sind optional ('' = nicht vorhanden). Die Vornamen müssen zusätzlich in den Trigger-Sätzen stehen, weil Trigger keine Variablen kennen. 'zonen_text' macht aus Zonennamen schöne Formulierungen; ohne Eintrag heißt es 'bei <Zone>'.
triggers:
  - trigger: conversation
    id: wo
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wo (ist|steckt|befindet sich) [die|der] (Arabella|Simon) [(gerade|aktuell|jetzt|momentan)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wo [die|der] (Arabella|Simon) [(gerade|aktuell|jetzt|momentan)] (ist|steckt)'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wo sich [die|der] (Arabella|Simon) [(gerade|aktuell|jetzt|momentan)] befindet'
      - ist [die|der] (Arabella|Simon) [(schon|noch|gerade)] (zu Hause|zuhause|daheim|unterwegs|da)
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wann (ist|kommt) [die|der] (Arabella|Simon) [wieder] (zu Hause|zuhause|daheim|nach Hause|heim|da)'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie lange (braucht|brauch) [die|der] (Arabella|Simon) [noch] [bis] (nach Hause|heim)'
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      personen:
        arabella:
          name: Arabella
          person: person.arabella_oberstedt
          ort: sensor.iphone15parabella_geocoded_location
          aktivitaet: sensor.iphone15parabella_activity
          fahrzeit: sensor.arabella_nach_hause
        simon:
          name: Simon
          person: person.simon_muller
          ort: sensor.iphone16psimon_geocoded_location
          aktivitaet: sensor.iphone16psimon_activity
          fahrzeit: sensor.simon_nach_hause
      zonen_text:
        Arbeit: auf der Arbeit
        Stadt: in der Stadt
        Fitnessstudio: im Fitnessstudio
      standort_alt_ab_min: 30
  - alias: Gefragte Person aus dem Satz lesen
    variables:
      p: '{% set satz = trigger.sentence | lower %}{% set ns = namespace(p=none) %}{% for k, v in personen.items() %}{% if ns.p is none and k in satz %}{% set ns.p = v %}{% endif %}{% endfor %}{{ ns.p }}'
  - alias: Fahrzeit frisch abrufen, wenn die Person unterwegs ist
    if:
      - condition: template
        value_template: '{{ p is mapping and p.fahrzeit | default('''') != '''' and not is_state(p.person, ''home'') }}'
    then:
      - action: homeassistant.update_entity
        target:
          entity_id: '{{ p.fahrzeit }}'
        continue_on_error: true
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- if p is not mapping -%}
      Diese Person kenne ich leider nicht.
      {%- else -%}
        {%- set ort = states(p.person) -%}
        {%- set ns = namespace(s=[]) -%}
        {%- if ort == 'home' -%}
          {%- set ns.s = ns.s + [p.name ~ ' ist zu Hause.'] -%}
        {%- elif ort in ['unknown', 'unavailable'] -%}
          {%- set ns.s = ns.s + ['Den Standort von ' ~ p.name ~ ' kenne ich gerade nicht.'] -%}
        {%- else -%}
          {%- set auto = p.aktivitaet | default('') != '' and is_state(p.aktivitaet, 'Automotive') -%}
          {%- if ort != 'not_home' -%}
            {%- set ns.s = ns.s + [p.name ~ ' ist gerade ' ~ zonen_text.get(ort, 'bei ' ~ ort) ~ '.'] -%}
          {%- else -%}
            {%- set stadt = state_attr(p.ort, 'Locality') if p.ort | default('') != '' else none -%}
            {%- set strasse = state_attr(p.ort, 'Thoroughfare') if p.ort | default('') != '' else none -%}
            {%- set wo = (' in ' ~ stadt ~ (', ' ~ strasse if strasse and not auto else '')) if stadt else '' -%}
            {%- set ns.s = ns.s + [p.name ~ ' ist ' ~ ('gerade mit dem Auto unterwegs' if auto else 'unterwegs') ~ (', aktuell' ~ wo if wo else '') ~ '.'] -%}
          {%- endif -%}
          {%- if p.fahrzeit | default('') != '' and has_value(p.fahrzeit) -%}
            {%- set m = states(p.fahrzeit) | float(0) | round(0) | int -%}
            {%- if m >= 2 -%}
              {%- set ns.s = ns.s + ['Bis nach Hause ' ~ ('sind es' if auto else 'wären es mit dem Auto') ~ ' etwa ' ~ m ~ ' Minuten.'] -%}
            {%- endif -%}
          {%- endif -%}
          {%- set alter = ((now() - states[p.person].last_updated).total_seconds() / 60) | round(0) | int -%}
          {%- if alter >= standort_alt_ab_min -%}
            {%- set ns.s = ns.s + ['Der Standort ist allerdings schon ' ~ (alter ~ ' Minuten' if alter < 120 else (alter / 60) | round(0) | int ~ ' Stunden') ~ ' alt.'] -%}
          {%- endif -%}
        {%- endif -%}
        {{- ns.s | join(' ') -}}
      {%- endif -%}
mode: queued
max: 3
Luftqualität: Sollte ich lüften?
Was sie kann: Bewertet den CO₂-Wert pro Raum oder für die ganze Wohnung, nennt bei Bedarf erhöhten Feinstaub und gibt eine Lüftungsempfehlung. Ist draußen viel Feinstaub, heißt es „nur kurz stoßlüften“.
Beispielsätze: „Wie ist die Luft im Schlafzimmer?“, „Sollte ich lüften?“, „Wie hoch ist der CO2-Wert im Studio?“
Du brauchst: einen CO₂-Sensor pro Raum, optional Feinstaub-Sensoren und einen Außensensor. Welche Sensoren wirklich genau messen, steht in meinem Luftsensoren-Vergleich.
Besonderheiten: Die Schwellen liegen bei 800 ppm (gut), 1.000 ppm (Lüften wäre gut) und 1.400 ppm (bitte lüften), alles in den Variablen änderbar.
Anpassen: Pro Raum Erkennungswörter, Name mit Präposition („im Studio“) und Sensoren. Neue Räume zusätzlich in den Trigger-Sätzen ergänzen.
alias: Luftqualität - Wie ist die Luft per Sprache
description: |-
  Beantwortet lokal per Assist 'Wie ist die Luft im Studio / Schlafzimmer / Kinderzimmer?', 'Wie ist die Luft in der Wohnung?' und 'Sollte ich lüften?'. Bewertet den CO2-Wert je Raum, nennt optional Feinstaub und gibt eine Lüftungsempfehlung. Der Außensensor entscheidet mit: Ist draußen viel Feinstaub, lautet die Empfehlung 'nur kurz stoßlüften'.

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)'. Pro Raum 'woerter' (Wortteile im Satz, klein), 'name' (mit Präposition, z. B. 'im Studio'), 'co2' und optional 'pm25'. Ohne Raum im Satz oder bei 'Wohnung' werden alle Räume bewertet. Neue Räume müssen zusätzlich in den Trigger-Sätzen stehen.
triggers:
  - trigger: conversation
    id: luft
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie ist die (Luft|Luftqualität) [(gerade|aktuell)] [(im|in der|in dem|in den)] [ganzen] [(Studio|Schlafzimmer|Kinderzimmer|Wohnung|Haus|Räumen)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] wie die (Luft|Luftqualität) [(gerade|aktuell)] [(im|in der|in dem)] [ganzen] [(Studio|Schlafzimmer|Kinderzimmer|Wohnung|Haus)] ist'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] [ob] (soll|sollte|muss) (ich|man|wir) [(gerade|jetzt|mal)] [(im|in der|in dem)] [(Studio|Schlafzimmer|Kinderzimmer|Wohnung)] [(gerade|jetzt|mal)] lüften'
      - muss [(im|in der|in dem)] [(Studio|Schlafzimmer|Kinderzimmer|Wohnung)] gelüftet werden
      - wie (ist|hoch ist) der (CO2-Wert|CO2 Wert|CO2-Gehalt|CO2 Gehalt|CO2) [(im|in der|in dem)] [(Studio|Schlafzimmer|Kinderzimmer|Wohnung)]
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      raeume:
        - woerter:
            - studio
          name: im Studio
          co2: sensor.airgradient_one_studio_kohlendioxid
          pm25: sensor.airgradient_one_studio_pm25
        - woerter:
            - schlafzimmer
          name: im Schlafzimmer
          co2: sensor.i_9psl_kohlendioxid
          pm25: sensor.i_9psl_pm25
        - woerter:
            - kinderzimmer
            - kizi
          name: im Kinderzimmer
          co2: sensor.meter_39f1_kohlendioxid
          pm25: ''
      aussen_co2: sensor.o_1pst_kohlendioxid
      aussen_pm25: sensor.o_1pst_pm25
      co2_gut_bis: 800
      co2_lueften_ab: 1000
      co2_schlecht_ab: 1400
      pm25_innen_hinweis_ab: 15
      pm25_aussen_schlecht_ab: 25
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- macro gross(s) -%}{{ s[0] | upper ~ s[1:] }}{%- endmacro -%}
      {%- macro liste(l) -%}{%- if l | count > 1 -%}{{ l[:-1] | join(', ') }} und {{ l[-1] }}{%- else -%}{{ l | join('') }}{%- endif -%}{%- endmacro -%}
      {%- set satz = trigger.sentence | lower -%}
      {%- set ns = namespace(s=[], r=[], einzel=false) -%}
      {%- for r in raeume -%}
        {%- set t = namespace(hit=false) -%}
        {%- for w in r.woerter -%}{%- if w in satz -%}{%- set t.hit = true -%}{%- endif -%}{%- endfor -%}
        {%- if t.hit -%}{%- set ns.einzel = true -%}{%- endif -%}
      {%- endfor -%}
      {%- for r in raeume -%}
        {%- set t = namespace(hit=false) -%}
        {%- for w in r.woerter -%}{%- if w in satz -%}{%- set t.hit = true -%}{%- endif -%}{%- endfor -%}
        {%- if (t.hit or not ns.einzel) and has_value(r.co2) -%}
          {%- set pm = states(r.pm25) | float(0) if r.get('pm25', '') and has_value(r.pm25) else none -%}
          {%- set ns.r = ns.r + [{'name': r.name, 'co2': states(r.co2) | float(0) | round(-1) | int, 'pm': pm}] -%}
        {%- endif -%}
      {%- endfor -%}
      {%- set aus_pm = states(aussen_pm25) | float(0) if aussen_pm25 and has_value(aussen_pm25) else none -%}
      {%- set aus_co2 = states(aussen_co2) | float(0) | round(-1) | int if aussen_co2 and has_value(aussen_co2) else none -%}
      {%- set draussen_schlecht = aus_pm is not none and aus_pm >= pm25_aussen_schlecht_ab -%}
      {%- if ns.r | count == 0 -%}
        {%- set ns.s = ['Dafür habe ich gerade keine Messwerte.'] -%}
      {%- elif ns.r | count == 1 -%}
        {%- set r = ns.r[0] -%}
        {%- set urteil = 'die Luft ist gut' if r.co2 < co2_gut_bis else ('die Luft ist noch in Ordnung' if r.co2 < co2_lueften_ab else ('die Luft ist verbraucht' if r.co2 < co2_schlecht_ab else 'die Luft ist schlecht')) -%}
        {%- set ns.s = ns.s + [gross(r.name) ~ ' liegt der CO2-Wert bei ' ~ r.co2 ~ ' ppm, ' ~ urteil ~ '.'] -%}
        {%- if r.pm is not none and r.pm >= pm25_innen_hinweis_ab -%}{%- set ns.s = ns.s + ['Der Feinstaub ist mit ' ~ r.pm | round(0) | int ~ ' Mikrogramm erhöht.'] -%}{%- endif -%}
        {%- if r.co2 >= co2_lueften_ab -%}
          {%- set ns.s = ns.s + [('Bitte lüften' if r.co2 >= co2_schlecht_ab else 'Lüften wäre gut') ~ (', wegen des Feinstaubs draußen aber nur kurz stoßlüften.' if draussen_schlecht else ('. Draußen sind es ' ~ aus_co2 ~ ' ppm.' if aus_co2 is not none else '.'))] -%}
        {%- else -%}
          {%- set ns.s = ns.s + ['Lüften ist nicht nötig.'] -%}
        {%- endif -%}
      {%- else -%}
        {%- set sortiert = ns.r | sort(attribute='co2', reverse=true) -%}
        {%- set lueften = sortiert | selectattr('co2', 'ge', co2_lueften_ab) | list -%}
        {%- set ok = sortiert | selectattr('co2', 'lt', co2_lueften_ab) | list -%}
        {%- if lueften | count == 0 -%}
          {%- set ns.s = ns.s + ['Die Luft ist überall in Ordnung, lüften ist nicht nötig.'] -%}
        {%- else -%}
          {%- set t = namespace(l=[]) -%}
          {%- for r in lueften -%}{%- set t.l = t.l + [r.name ~ ' mit ' ~ r.co2 ~ ' ppm'] -%}{%- endfor -%}
          {%- set ns.s = ns.s + ['Lüften solltest du ' ~ liste(t.l) ~ (', wegen des Feinstaubs draußen aber nur kurz stoßlüften.' if draussen_schlecht else '.')] -%}
        {%- endif -%}
        {%- if ok | count > 0 -%}
          {%- set t = namespace(l=[]) -%}
          {%- for r in ok -%}{%- set t.l = t.l + [r.name ~ ' ' ~ r.co2] -%}{%- endfor -%}
          {%- set ns.s = ns.s + [('Gut sieht es aus ' if lueften | count > 0 else 'Die Werte: ') ~ liste(t.l) ~ ' ppm.'] -%}
        {%- endif -%}
      {%- endif -%}
      {{- ns.s | join(' ') -}}
mode: queued
max: 3
Waschmaschine: Läuft sie noch oder ist sie fertig?
Was sie kann: Sagt, ob die Waschmaschine gerade läuft (seit wann und mit wie viel Watt) oder seit wann sie fertig ist.
Beispielsätze: „Ist die Waschmaschine fertig?“, „Läuft die Waschmaschine noch?“
Du brauchst: einen Binärsensor, der anzeigt, ob die Maschine läuft (zum Beispiel aus einer Leistungsmessung), und optional den Leistungssensor.
Besonderheiten: Lohnt sich vor allem, wenn die Maschine wie bei mir im Waschkeller steht und du nicht mal eben nachschauen kannst.
Anpassen: Name, Binärsensor und Leistungssensor in Variablen (hier anpassen).
alias: Hausgeräte - Läuft oder fertig per Sprache
description: |-
  Beantwortet lokal per Assist 'Ist die Waschmaschine fertig?', 'Läuft die Waschmaschine gerade?' und 'Ist die Waschmaschine in Benutzung?'. Sinnvoll, weil die Waschmaschine nicht in der Wohnung steht (Waschkeller). Andere Geräte sind bewusst NICHT enthalten (Simon, 18.09.2026).

  ANPASSEN: erste Aktion 'Variablen (hier anpassen)'. 'aktiv' = binary_sensor (on = läuft), daraus kommt auch 'fertig seit ...'; 'leistung' = optionaler Leistungssensor in Watt.
triggers:
  - trigger: conversation
    id: waschmaschine
    command:
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] [ob] (ist|läuft) die Waschmaschine [(schon|gerade|noch|aktuell)] [(fertig|durch|an|aus|frei|in Benutzung|am Laufen|besetzt|belegt)]'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] ob die Waschmaschine [(schon|gerade|noch|aktuell)] (fertig ist|durch ist|läuft|an ist|frei ist|in Benutzung ist|belegt ist)'
      - '[(kannst du mir [bitte] sagen|sag mir [bitte]|weißt du)] (wann|wie lange) (ist|braucht|läuft) die Waschmaschine [noch] [fertig]'
      - ist die Wäsche [schon] (fertig|durch)
conditions: []
actions:
  - alias: Variablen (hier anpassen)
    variables:
      name: die Waschmaschine
      aktiv: binary_sensor.waschmaschine
      leistung: sensor.waschmaschine_power
  - alias: Antwort formulieren
    set_conversation_response: |-
      {%- macro gross(s) -%}{{ s[0] | upper ~ s[1:] }}{%- endmacro -%}
      {%- macro uhr(d) -%}{{ d.hour }} Uhr{{ ' ' ~ d.minute if d.minute else '' }}{%- endmacro -%}
      {%- if not has_value(aktiv) -%}
      Von der Waschmaschine bekomme ich gerade keine Daten.
      {%- elif is_state(aktiv, 'on') -%}
        {%- set watt = states(leistung) | float(0) | round(0) | int if leistung and has_value(leistung) else 0 -%}
        {%- set seit = states[aktiv].last_changed | as_local -%}
      {{ gross(name) }} läuft gerade noch, seit {{ uhr(seit) }}{{ ', aktuell mit ' ~ watt ~ ' Watt' if watt > 0 else '' }}.
      {%- elif states[aktiv].last_changed | as_local > today_at('00:00') -%}
      {{ gross(name) }} ist fertig, seit {{ uhr(states[aktiv].last_changed | as_local) }}.
      {%- else -%}
      {{ gross(name) }} läuft gerade nicht und ist frei.
      {%- endif -%}
mode: queued
max: 3
8. Bonus: Internetzugriff ohne Cloud-KI
Ein lokales Modell weiß nichts über Öffnungszeiten, Preise oder Nachrichten. Man kann ihm trotzdem eine Websuche geben, ohne die Steuerung in die Cloud zu verlagern: Das Modell ruft ein Home-Assistant-Skript auf, das Skript fragt eine selbst gehostete SearXNG-Instanz, das Modell formuliert aus den Treffern die Antwort. Ohne Konto, ohne Schlüssel, ohne Limit. Drei Dinge habe ich dabei gelernt: Die JSON-Ausgabe von SearXNG ist standardmäßig aus und muss in der settings.yml aktiviert werden. Drei Treffer reichen nicht, es müssen rund acht sein, weil die Reihenfolge zwischen Aufrufen schwankt. Und die Skript-Beschreibung entscheidet, wann das Modell sucht. „Nur verwenden, wenn die Antwort aktuell, lokal oder veränderlich ist“ funktioniert deutlich besser als „für Faktenfragen“.
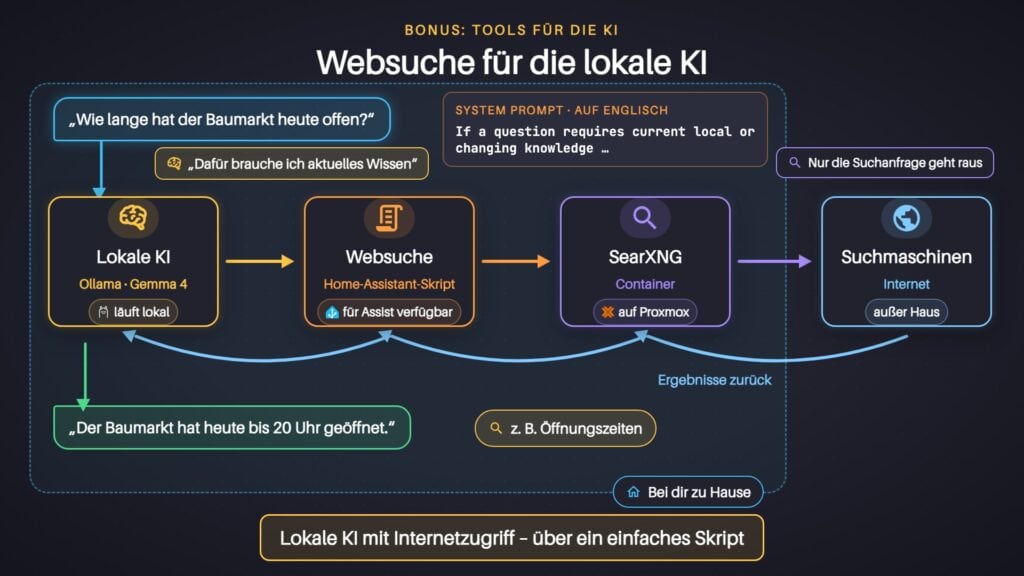
Websuche über SearXNG: komplette Datei (Paket)
So richtest du es ein: Die Anleitung steht im Kopf der Datei. Kurz: SearXNG als Container starten, dort die JSON-Ausgabe aktivieren, die Datei nach config/packages/websuche_searxng.yaml legen, die URL anpassen, Home Assistant neu starten und das Skript „Web Suche“ für Assist freigeben.
Voraussetzung: In deiner configuration.yaml muss der Packages-Ordner eingebunden sein (steht ebenfalls im Kopf der Datei).
# ---------------------------------------------------------------------------
# Websuche fuer Assist ueber SearXNG
# ---------------------------------------------------------------------------
# Gibt dem Sprachassistenten ein Werkzeug an die Hand, mit dem er aktuelle
# Informationen aus dem Internet nachschlagen kann. Komplett lokal, kostenlos,
# ohne API-Schluessel und ohne Kontingent.
#
# VORAUSSETZUNGEN
# ---------------
# 1) Ein laufender SearXNG-Container, z. B.:
#
#      docker run -d --name searxng -p 8888:8080 \
#        -v searxng-config:/etc/searxng --restart unless-stopped \
#        searxng/searxng:latest
#
# 2) In dessen /etc/searxng/settings.yml muss die JSON-Ausgabe aktiv sein.
#    Standardmaessig ist sie AUS. Ergaenzen und Container neu starten:
#
#      search:
#        formats:
#          - html
#          - json
#
# 3) In der configuration.yaml muss der Packages-Ordner eingebunden sein:
#
#      homeassistant:
#        packages: !include_dir_named packages
#
# 4) Diese Datei nach  config/packages/websuche_searxng.yaml  legen,
#    die URL unten anpassen und Home Assistant neu starten.
#
# 5) Danach unter Einstellungen -> Sprachassistenten -> Assist das Skript
#    "Web Suche" freigeben. Erst dann sieht das Sprachmodell das Werkzeug.
#
# 6) Empfohlene Ergaenzung im System-Prompt des Sprachassistenten:
#
#      Wenn eine Frage aktuelles, oertliches oder sich aenderndes Wissen
#      erfordert, das du nicht selbst kennst, nutze das Tool 'web_suche'.
#      Gib dabei nur die Suchbegriffe ein, nicht die ganze Frage.
#
# ANPASSEN: Die IP/den Port des eigenen SearXNG eintragen.
# ---------------------------------------------------------------------------

rest_command:
  searxng_suche:
    url: >-
      http://192.168.0.70:8888/search?q={{ frage | urlencode }}&format=json&language=de
    method: GET
    content_type: "application/json"
    timeout: 20

script:
  web_suche:
    alias: Web Suche
    icon: mdi:web
    mode: single
    # Diese Beschreibung liest das Sprachmodell. Sie entscheidet darueber,
    # ob das Werkzeug im richtigen Moment aufgerufen wird - also ruhig
    # ausfuehrlich und mit Beispielen formulieren.
    description: >-
      Sucht Informationen im Internet. Nur verwenden, wenn die Antwort
      aktuell, lokal oder veraenderlich ist - etwa Oeffnungszeiten, Adressen,
      Preise, Termine, Nachrichten oder Sportergebnisse. Nicht verwenden fuer
      Allgemeinwissen, das du bereits kennst, und nicht fuer Fragen zu
      Geraeten und Zustaenden im Haus. Liefert Suchtreffer mit
      Textausschnitten; formuliere daraus selbst eine kurze Antwort.
    fields:
      frage:
        name: Suchanfrage
        description: >-
          Nur die Suchbegriffe, nicht die ganze Frage.
          Statt "Wann hat der Tierpark in Musterstadt offen?" besser
          "Tierpark Musterstadt Oeffnungszeiten".
        required: true
        example: Tierpark Musterstadt Oeffnungszeiten
        selector:
          text:
    sequence:
      - alias: SearXNG abfragen
        action: rest_command.searxng_suche
        data:
          frage: "{{ frage }}"
        response_variable: suche

      # WARUM ACHT TREFFER?
      # SearXNG fragt mehrere Suchmaschinen parallel ab. Welche rechtzeitig
      # antworten, schwankt von Aufruf zu Aufruf - und damit auch die
      # Reihenfolge. Gemessen an der Beispielfrage "Tierpark Musterstadt
      # Oeffnungszeiten" lagen die Treffer mit der tatsaechlichen Zeitangabe
      # auf den Positionen 1, 2, 3 UND 7. Mit nur drei Treffern erwischt man
      # die Antwort also mal - und mal nicht. Acht Treffer a ~220 Zeichen
      # kosten rund 500 Token und passen auch in einen 8K-Kontext.
      #
      # SearXNG liefert drei Sorten von Ergebnissen. Die ersten beiden sind
      # deutlich wertvoller als die klassischen Treffer, weil sie aus
      # strukturierten Quellen stammen (Wikidata & Co.) statt aus
      # SEO-optimierten Textanreissern:
      #
      #   answers    - direkte Kurzantwort auf die Frage
      #   infoboxes  - Wissens-Steckbrief mit Eigenschaften
      #   results    - die normalen Suchtreffer
      #
      # Deshalb stehen sie hier oben und werden zuerst ausgewertet.
      - alias: Ergebnisse aufbereiten
        variables:
          antworten: "{{ suche.content.answers | default([], true) }}"
          steckbriefe: "{{ suche.content.infoboxes | default([], true) }}"
          treffer: "{{ suche.content.results | default([], true) }}"
          result:
            ergebnis: >-
              {%- if antworten | count > 0 %}
              DIREKTE ANTWORT:
              {%- for a in antworten %}
              {{ a.answer if a is mapping else a }}
              {%- endfor %}
              {% endif -%}

              {%- if steckbriefe | count > 0 %}
              {%- set box = steckbriefe[0] %}
              STECKBRIEF: {{ box.infobox | default('', true) }}
              {{ (box.content | default('', true)) | truncate(400, true) }}
              {%- for attr in box.attributes | default([], true) %}
              - {{ attr.label | default('', true) }}: {{ attr.value | default('', true) }}
              {%- endfor %}
              {% endif -%}

              {%- if treffer | count > 0 %}
              SUCHTREFFER:
              {%- for t in treffer[:8] %}
              {{ loop.index }}. {{ t.title }}
              {{ (t.content | default('', true)) | truncate(220, true) }}
              Quelle: {{ t.url | default('', true) }}
              {%- endfor %}
              {%- endif %}

              {%- if (antworten | count) + (steckbriefe | count) + (treffer | count) == 0 %}
              Keine Suchergebnisse gefunden.
              {%- endif %}

      - stop: fertig
        response_variable: result
🏠 Im Alltag: Was gut geht, was nervt
✅ Was gut geht:
- Rollos, Lichter, Szenen: schnell, deutsch, zuverlässig, sobald die Sätze sitzen.
- Alles mit eigenem Satz-Auslöser, also Müll, Sonne, Wetter, Paket und Co.: in Sekundenbruchteilen und immer gleich formuliert. Da hängt lokal die Cloud tatsächlich ab.
- Zustandsfragen: „Welche Rollos sind geschlossen?“ nennt gemma4 alle neun korrekt, inklusive der, die es auslassen soll (Garage, Auto).
- Wetter und Öffnungszeiten über die Skripte. Die erste Sprachanfrage über die komplette Kette hat auf Anhieb die richtigen Öffnungszeiten vorgelesen.
- Das Modell hält sich an die Sprechbarkeitsregel: „21,3 Grad“, „von 13 bis 18 Uhr“.
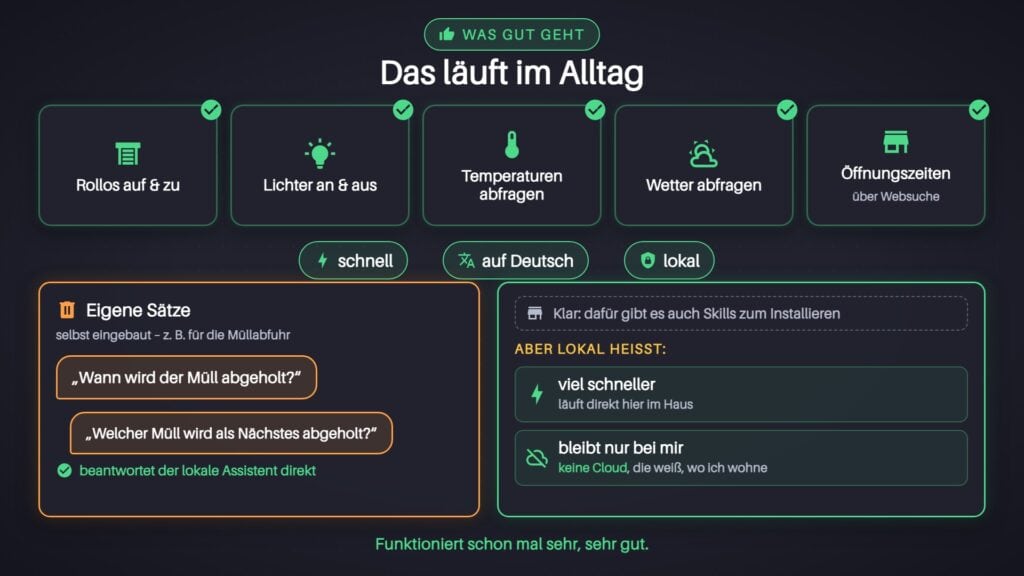
❌ Was nervt:
- „Wie warm ist es draußen?“ und „Wie warm ist es im Garten?“ sind für den Assistenten zwei verschiedene Dinge, solange es mehrere Außensensoren gibt oder kein eigener Satz dafür existiert. Mal nennt er den Garten, mal den Balkon, mal behauptet er, keinen Zugriff auf die Wettervorhersage zu haben. Meine Lösung ist die Wetter-Automation oben, die genau diese Sätze abfängt.
- Lichter zählen ist die instabilste Frage im Feld. Gemma 4 lag bei mir meistens richtig, aber eben nicht immer, und andere Modelle liefern in zwei Durchgängen verschiedene Zahlen. Zuverlässiger ist ein eigener Satz, der deterministisch zählt. Dann muss das Modell nichts mehr rechnen.
- Vage Anfragen wie „Mach mal gemütlich“ enden je nach Modell in geratenen Aktionen.
- „Rollo“ behandelt Home Assistant intern als Jalousie. Der eingebaute Satz trifft dann keine oder nur bestimmte Geräte. Wie ich das mit eigenen Sätzen gelöst habe, steht in Abschnitt 7.
- Freigegebene Geräte pflegen ist Arbeit, die nie fertig ist. Jedes neue Gerät will einen Namen, einen Bereich und die Entscheidung, ob es rein soll.
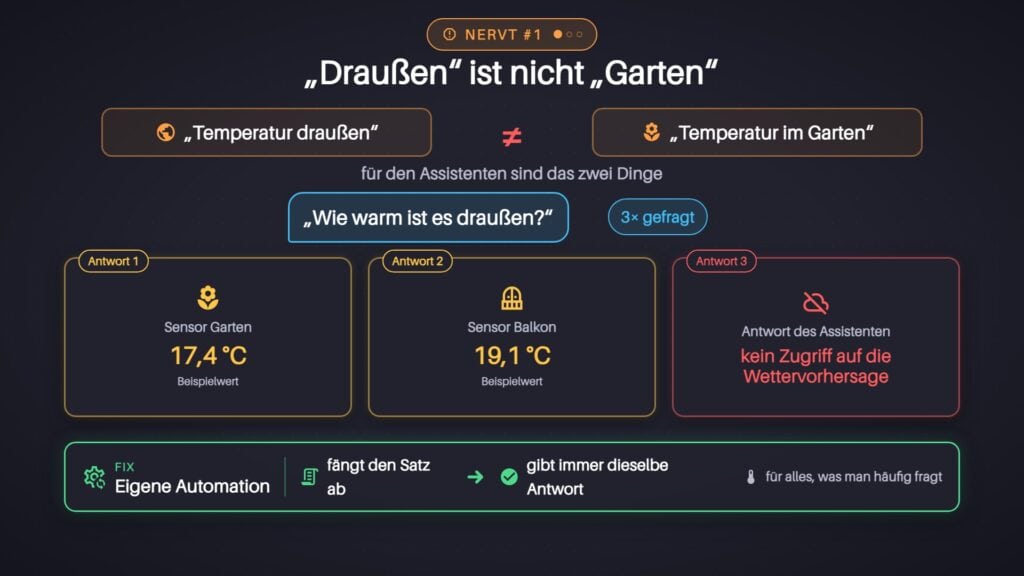
Mein Umbau: Spracherkennung aus der Cloud, KI weiter lokal
Die wichtigste Erkenntnis aus dem Alltag betrifft gar nicht die KI, sondern Sprache-zu-Text und Sprachausgabe. Lokal brauchen Whisper und Piper bei mir zusammen 2,5 bis 3 Sekunden, und das auf wirklich schneller Hardware. Home Assistant Cloud schafft dasselbe in 0,2 bis 0,5 Sekunden, ein himmelweiter Unterschied. Dazu erkennt die Cloud auch genuschelte Befehle deutlich zuverlässiger als Whisper (und ich nuschle gern). Bei Nabu Casa bin ich mir außerdem sehr sicher, dass die Daten privat bleiben: Das steht so in den Bedingungen, und Datenschutz ist ihr Aushängeschild.
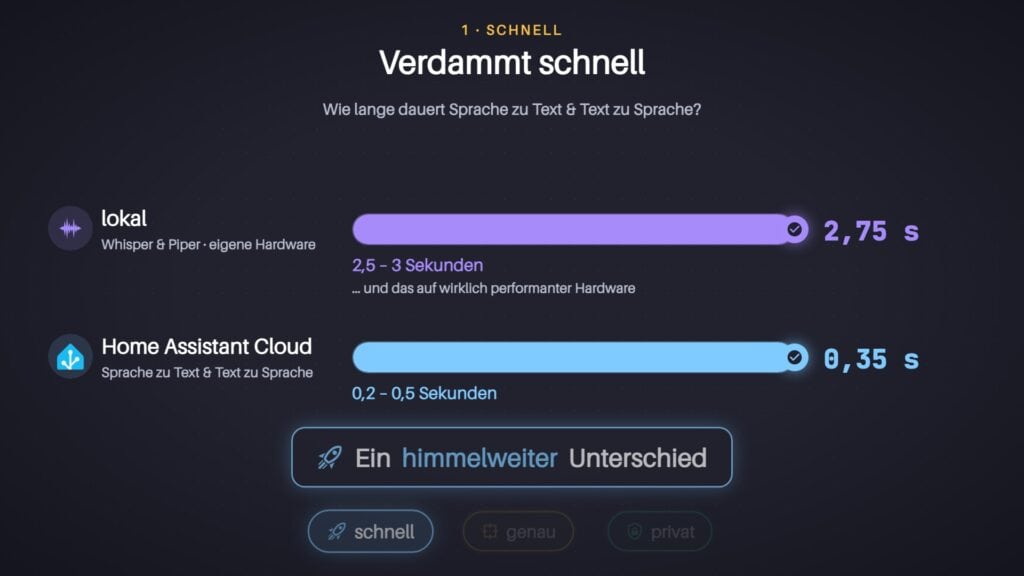
Deshalb läuft bei mir jetzt eine Mischung: Sprache-zu-Text und Sprachausgabe über Home Assistant Cloud, das Sprachmodell weiter lokal, solange ich die Hardware dafür habe. Fällt das Internet aus, schaltet eine Automation alle Satelliten automatisch auf die komplett lokale Pipeline mit Whisper und Piper um. Für den Notfall reicht dann vermutlich auch das kleinere Whisper-Modell medium statt large.
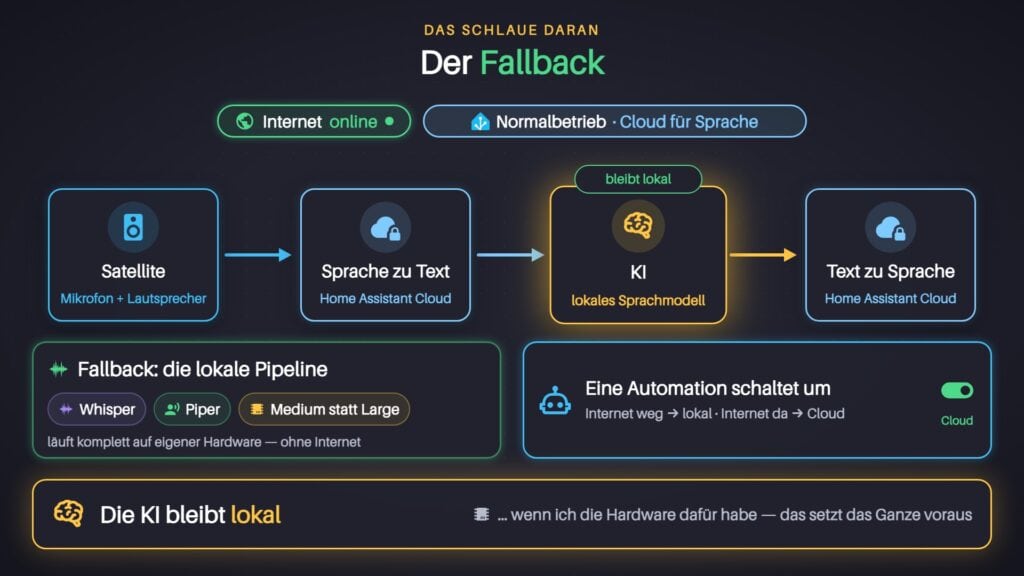
Was meine Frau dazu sagt
Ich bin sehr zufrieden. Arabella noch nicht so wirklich. Und das ist der ehrlichste Maßstab, den ich habe: Ich weiß, wie die Geräte heißen, welche Sätze lokal laufen und warum „draußen“ nicht „Garten“ ist. Sie will einfach, dass es geht.
Ihr Fazit, zusammengefasst: Es funktioniert, aber mit Eingewöhnung. Man muss ein bisschen dranschrauben, damit die wichtigen Fragen lokal und damit schnell laufen. Dann ist es ein echter Mehrwert gegenüber vorher. Aber die Formulierungen müssen sitzen. Genau da sind Alexa und Co. nach Jahren Training mit Millionen von Haushalten eben weiter. Noch.
🏁 Fazit
Ja, lokale Sprachsteuerung mit Home Assistant geht 2026. Mit dem Funktionsumfang eines echten Assistenten, auf Deutsch, in wenigen Sekunden, ohne dass ein Byte das Haus verlässt. Aber:
- Für wen: Wer gern bastelt und Datenschutz ernst nimmt, kann komplett lokal gehen. Wer den Komfort von Alexa oder die Qualität der großen Cloud-Assistenten will, muss viel investieren oder lässt es besser.
- Kosten ehrlich: Satellit 40 bis 150 Euro pro Raum. Eine KI-Kiste für ein Modell, das sich nach echter KI anfühlt: rund 500 Euro, wenn du schon einen Rechner hast und nur eine Grafikkarte brauchst, bis rund 2.000 Euro komplett neu. Die 16-GB-Klasse ist ein Kompromiss, der Raspberry Pi mit AI HAT+ 2 funktioniert leider nicht.
- Lokal ist keine Sparmaßnahme. Dieselbe Nutzung kostet bei Mistral in der EU-Cloud rund 50 Dollar im Jahr, Strom noch gar nicht eingerechnet. Lokal kaufst du Unabhängigkeit, nicht Ersparnis.
- Die größten Hebel sind nicht Hardware-Tuning, sondern „Lokale Verarbeitung bevorzugen“, eine kurze und saubere Geräteliste, Thinking aus und eigene Sätze für alles, was du täglich sagst.
Meine Empfehlung für die meisten: Aktuell ist es sinnvoller, das Sprachmodell in der Cloud zu betreiben, zum Beispiel mit Mistral, und daneben eigene Sätze und Sprach-Automationen so weit auszubauen, dass so gut wie alles Tägliche lokal erkannt wird. Dann bleiben für die Cloud nur die Anfragen übrig, für die du ohnehin ein intelligentes Modell brauchst. Lokal geht, aber damit es wirklich intelligent ist, musst du ordentlich investieren.
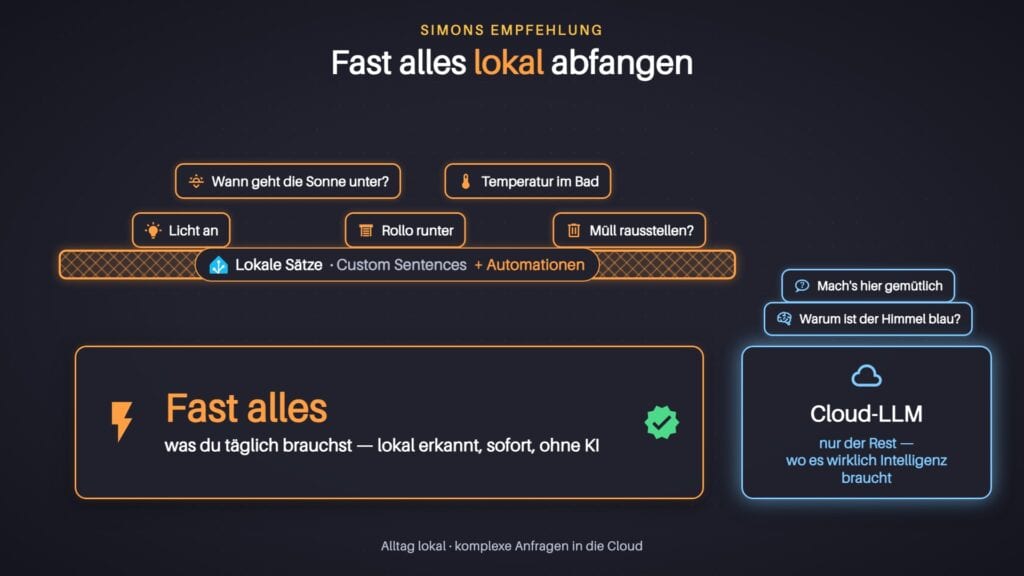
Ich habe übrigens sogar versucht, ein eigenes deutsches Modell für Home Assistant zu trainieren, das schalten und Zustände abfragen kann. Zuverlässig läuft das bisher nicht, dafür stecke ich vermutlich nicht tief genug drin. Wenn du dich damit besser auskennst als ich: Meld dich gern in der simon42 Community.
Und jetzt du: Was soll ins nächste Sprachassistenten-Video? Die sinnvolle Mischung aus Cloud und lokal im Detail oder der automatische Rückfall auf lokal, wenn das Internet weg ist? Schreib es mir gern in die Kommentare unter dem Video.
Wenn du lieber bei den klassischen Sprachassistenten bleibst, sind das die passenden Anleitungen:
📖 Home Assistant mit Alexa verbinden: https://www.simon42.com/home-assistant-alexa/
📖 Home Assistant mit Google Home verbinden: https://www.simon42.com/home-assistant-google-home/





Beginnen die Diskussion unter community.simon42.com